


数据结构:数据科学家指南
这篇文章帮助数据从业者理解基本数据结构,从而编写速度更快、内存效率更高的代码。
数据处理脚本中常见的瓶颈,例如缓慢的特征工程循环和低效的查找,通常可以追溯到任务与底层数据结构之间的不匹配。这些性能瓶颈的根本原因往往不在于代码逻辑,而在于数据在内存中的组织方式。理解这些结构及其优缺点是编写高效且可扩展的分析流程的基本技能。本文将提炼哈佛大学著名的 CS50x 课程中关于数据结构的关键知识,并将这些计算机科学基础知识直接应用于数据分析和数据科学的实际应用中。
1. 数组及其隐藏的调整大小成本
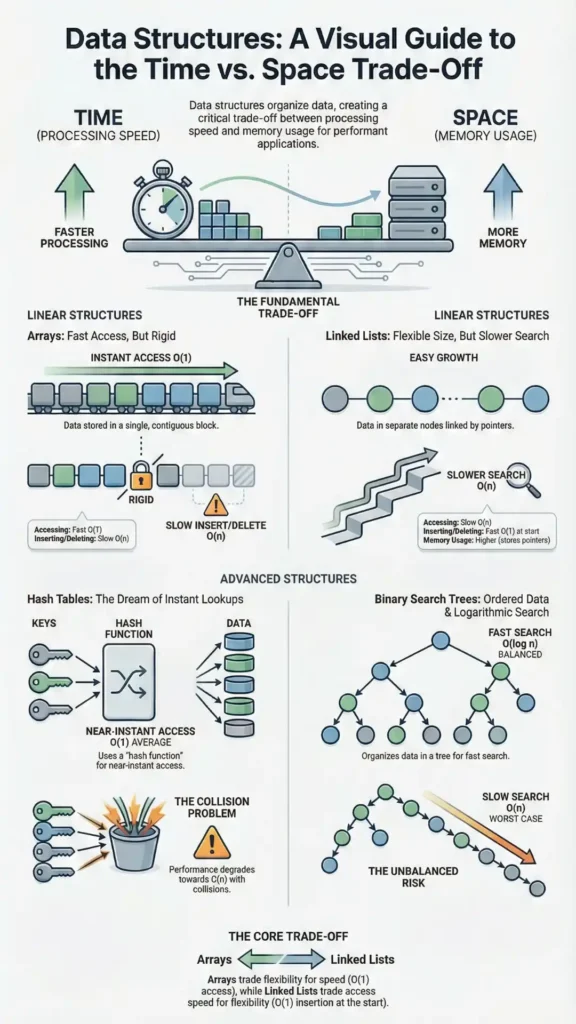
数组是一种简单的数据结构,其中相同类型的元素在内存中背靠背(“连续”)存储。这种连续布局使得通过索引访问任何元素都非常快速。然而,数组有一个关键的限制:必须预先确定其大小。
当需要“扩展”一个已经满的数组时会发生什么?如果末尾的内存空间已被占用,你不能简单地添加新元素。唯一的解决办法是分配一块全新的、更大的内存块,手动将旧数组中的每个元素复制到新数组中,然后释放原数组占用的内存。这种复制过程非常耗时,属于“线性时间”操作——数组越大,所需时间越长。
数据科学连接
许多常用的数据工具,例如 Python 列表,都表现得像“动态数组”。虽然它们看起来会自动增长,但实际上底层会执行代价高昂的调整大小操作。为了加快追加操作的速度,Python 列表会使用 超额分配——预留额外的空间——这使得 追加操作的均摊时间复杂度 为常数(均摊 O(1))。然而,在大型列表的开头插入元素速度很慢,不仅是因为可能需要调整大小,还因为需要将 后续每个元素 向右移动一个位置,这直接增加了 O(n) 的时间复杂度。
2. 链表:以连续内存换取灵活性
链表解决了数组难以灵活调整大小的问题。链表并非将元素连续存储,而是一系列可以位于内存中任意位置的“节点”。每个节点包含两部分:一段数据和一个指向下一个节点位置的“指针”(地址)。这样,就可以根据需要将可用的内存空间“拼接”在一起。
这种结构引入了一个主要的权衡取舍:
- 上行空间: 列表可以动态增长和缩减,无需移动所有现有元素。这可以更有效地利用碎片化的内存。
- 下行: 它总体上占用更多内存,因为每个元素都需要一个额外的指针来存储下一个元素的地址。
- 关键缺点: 您将失去执行快速二分查找的能力。由于元素并非连续存储,您无法立即跳转到列表中间;您必须从列表开头逐个节点遍历。
数据科学连接
考虑一个实时事件日志,其中可能需要根据更新在序列中间插入或删除事件。一个标准的 Python 脚本可以实现这一点。 list would be punishingly slow for this, as each operation could require shifting many elements. A structure like Python’s collections.deque, however, is implemented using a doubly-linked list, providing fast O(1) appends and pops from 两者 结束。
3. 反直觉的真相:最快的列表是反向构建的
在使用链表时,添加新元素的方式对性能影响巨大。要将新节点添加到链表 开头 (即前置操作),只需创建新节点并更新链表头部的几个指针即可。此操作与链表的总大小无关。
这使得在列表前添加节点成为 常数时间 (O(1)) 操作——速度极快。相比之下,要在列表 末尾 添加新节点(追加),必须先从列表开头遍历整个列表才能找到最后一个节点。这使得追加操作成为 linear time (O(n)) 操作,并且随着列表的增长而逐渐变慢。
令人惊讶的是,从零开始构建链表的最佳方法是将每个新元素添加到链表头部。这意味着,如果您先插入数字 1,然后插入 2,最后插入 3,内存中的最终链表顺序将是 3 -> 2 -> 1。
数据科学连接
这是一个经典的例子,说明看似简单的选择——在前端添加数据还是在后端添加数据——如何对性能产生巨大的影响(O(1) 与 O(n))。这凸显了理解我们在数据清洗和特征工程脚本中日常操作的时间复杂度的重要性。一个运行缓慢的循环可能隐藏着一个可以优化的线性时间操作。
4. 二叉搜索树:快速搜索但可能退化
二叉搜索树 (BST) 试图结合有序数组的快速搜索能力和链表的动态调整大小功能。它是一种节点树,每个节点最多可以有两个子节点。其结构遵循“二分查找特性”:对于任意给定的节点,其左子树中的所有值都小于该节点,而其右子树中的所有值都大于该节点。
这种特性使得只需沿着树的左右指针向下查找即可进行二分查找,平均而言可以实现高效的 对数时间复杂度 (O(log n)) 。然而,二叉搜索树存在一个关键缺陷。在“反常情况”下,如果插入的数据已经排序(例如,先插入 1,再插入 2,再插入 3,最后插入 4),树就会完全失去平衡。每个新节点都会被添加到前一个节点的右侧。
在这种最坏的情况下,二叉搜索树“退化成链表”。其搜索性能从对数时间降级为缓慢的 linear time (O(n)).
数据科学连接
不平衡的二叉搜索树(BST)生动地比喻了平均性能和最坏性能之间的差异。在数据科学中,输入数据的分布和顺序会显著影响算法的效率。因此,通常基于树状结构的数据库索引需要复杂的“平衡”算法来持续进行自我重组,以防止最坏情况的发生。
5. 哈希表:实现常数时间复杂度的实用方法
哈希表是实现字典的首选数据结构,字典用于存储键值对。它巧妙地结合了数组和链表,实现了近乎瞬时的查找。其核心组件包括:
- An 排列 “桶”。
- A 哈希函数 它接受一个键(例如,一个人的名字),并确定性地将其转换为数组的索引。
- 链表 在每个桶内处理“冲突”——即两个不同的键哈希到同一个数组索引的情况。
讲座中用Sweetgreen的取货货架作比喻,完美地阐释了这一点。订单上的名字就是 关键。员工根据你名字的首字母选择货架(AE、FJ等等),这就像是 哈希函数。货架本身就是 桶 (数组中的一个索引)。你需要扫描货架上的几份沙拉,就相当于用于处理冲突的 链表 。虽然理论上最坏情况下的 linear time (O(n)) 即所有键都冲突形成一个很长的链表,但实际的平均性能却非常接近 常数时间 (O(1)).
“是的,哈希表的技术复杂度是 N 除以 K,也就是大 O(n),但实际上,如果你足够聪明,并且巧妙地使用了哈希函数……那么发生冲突的概率会非常低,即使偶尔会出现线性时间复杂度的情况,但大多数情况下它仍然是常数时间复杂度,也就是大 O(1)。”——哈佛 CS50x 2025(YouTube)——讲座:数据结构
数据科学连接
哈希表是 Python 字典背后的引擎(dict) and sets (set). This is why key lookups (my_dict['key']) and membership testing (item in my_set) are exceptionally fast. These structures are fundamental tools for performant data manipulation, creating lookup tables, aggregating data by category, and building features efficiently.
今天申请什么
- 对于键值查找,始终优先选择字典/哈希表。 过度搜索键值对列表。在大数据集上,O(1) 和 O(n) 之间的性能差异非常巨大。
- 当性能至关重要时,要注意数据顺序。 正如二叉搜索树所示,将排序后的数据插入某些结构中可能会触发最坏情况行为。
- 询问您的数据是否需要排序。 如果你只需要快速查找和成员资格测试,那么集合(基于哈希)比列表效率高得多。
- 将底层操作可视化。 当脚本运行缓慢时,想想你是否在循环中强制执行线性 O(n) 操作,从而无意中造成了 O(n²) 的复杂度。
- 认识到时间和空间之间的权衡。 哈希表(例如 Python 哈希表)
dict) consumes more memory than a list to store its hash values and pointers, but it buys you dramatically faster lookups—a trade-off that is essential to writing performant code.
关闭
核心观点是,每种数据结构都代表着时间、空间和实现复杂度之间的一种权衡。没有所谓的“最佳”结构,只有最适合当前任务的结构。接下来,讲座转向Python,这种语言抽象化了我们讨论过的许多手动内存管理细节。然而,性能原则仍然至关重要,因为这些结构仍然在底层运行。你现在会重新思考你每天使用的哪些数据结构呢?




