Scikit-Learn 线性回归:综合指南
您将通过 scikit-learn 学习线性回归预测建模的艺术和科学。
介绍
线性回归是数据科学中的一项基础技术,可以预测和解释变量之间的关系。线性回归的核心是对因变量与一个或多个自变量之间的关系进行建模,使用线性方程来预测结果。这种简单性及其可解释性使线性回归成为各个学科的数据分析师和科学家的重要工具。
本文旨在提供一份关于如何使用使用 scikit-learn 进行线性回归(一个流行的 Python 机器学习库)实现线性回归的全面指南。scikit-learn 提供了丰富的 数据分析 和建模工具及算法,使其成为该领域初学者和经验丰富的从业者的理想选择。
在本指南中,我们将深入研究线性回归的理论基础和实际应用。从基础知识开始,我们将探讨线性回归模型背后的假设和数学。从那里,我们将过渡到使用 scikit-learn 准备数据、构建线性回归模型并解释其结果的实用示例。为了说明这些概念,我们可以利用之前创建的数据集,演示从数据预处理到模型评估的线性回归分析的过程。
通过将理论知识与实践技能相结合,本指南旨在帮助读者全面了解 scikit-learn 背景下的线性回归,为他们将这些概念应用于现实世界的数据科学挑战做好准备。
核心亮点
- 使用 scikit-learn 进行线性回归可以非常准确地预测结果。
- Scikit-learn 的 API 将复杂的统计分析简化为易于理解的步骤。
- scikit-learn 中的数据预处理增强了模型的可靠性和完整性。
- scikit-learn 中的先进技术可解决过度拟合问题,提高模型精度。
- 线性回归与 scikit-learn 的实际应用可推动做出有影响力的决策。
广告标题
广告描述。 Lorem ipsum dolor sat amet,consectetur adipiscing elit。
了解线性回归
线性回归是一种关键的统计方法,它揭示了两个或多个变量之间的潜在关系。将线性方程与观察到的数据进行拟合使我们能够根据另一个变量的知识来理解和预测一个变量的行为。这种预测建模技术不仅仅是找到一条最适合数据的线,而且还揭示隐藏在数据中的真相,从而做出明智的决策。
线性回归的核心是在一组确保其实际应用的假设下运行:
线性度:自变量和因变量之间的关系是线性的。这一基本假设意味着,自变量的变化会导致因变量成比例的变化。
独立性:观测值彼此独立。每个数据点的结果不依赖于其他数据点的结果。
同方差性:误差项(残差)的方差在所有自变量水平上保持不变。同方差性确保模型的预测精度在自变量的整个范围内保持一致。
误差的正态分布:对于任何给定的自变量值,因变量的误差服从正态分布。这一假设使我们能够对代表自变量的系数进行推断和假设检验。
理解这些假设对于充分应用线性回归至关重要,因为违反这些假设可能会导致模型不准确和误导结果。通过确保数据满足这些先决条件,从业者可以充分利用线性回归的潜力,使其成为解释复杂数据集的强大工具。
使用 scikit-learn 进行线性回归涉及准备数据以满足这些假设,然后进行模型拟合、评估和解释。通过这个过程,scikit-learn 的线性回归不再只是一个数学公式,而是数据与决策、理论与应用之间的桥梁,引导我们做出更明智、更准确的预测。
Scikit-Learn 简介
Scikit-learn 是数据科学领域的标杆,它体现了推动该领域创新的协作精神和开源理念。作为一个库,scikit-learn 提供了一套全面的机器学习工具,涵盖数据预处理、模型选择、评估和调优等各个方面。其设计原则优先考虑易用性、性能和通用性,既能让新手轻松上手,又能满足专家级从业者的需求。
图书馆对高质量文档和社区参与的承诺进一步体现了科学和教育目的软件开发的最佳实践。 Scikit-learn 是一个算法集合,也是一个用于学习、实验和发现的平台。其架构鼓励数据建模的最佳实践,确保用户可以访问最先进的机器学习技术并理解其原理。
借助 scikit-learn 进行线性回归及其他相关操作,数据科学家可以自信且清晰地构建预测模型。该库通过`LinearRegression`类实现了线性回归,提供了一个强大而直观的接口,用于将模型拟合到数据、分析其性能并进行预测。无论您是探索简单的线性关系,还是深入研究更复杂的多维数据集,scikit-learn 都能作为可靠的指南,引导您掌握机器学习的精髓,它凝聚了全球数据科学社区的集体智慧和努力。
准备您的数据
在使用 scikit-learn 进入建模阶段之前,必须仔细准备数据,以确保分析的完整性和真实性。数据预处理是机器学习流程中的关键步骤,包括清理、选择特征以及将数据拆分为训练集和测试集。
特征选择:首先确定对因变量影响最大的特征。并非所有数据点都同等重要;有些数据点可能对结果影响甚微甚至没有影响,如果纳入分析反而会引入噪声。
数据清理:此步骤涉及处理缺失值、异常值以及可能影响模型结果的错误数据。处理缺失数据的方法包括插补、基于其他数据点填充缺失值、省略以及删除包含缺失值的数据点或特征。
数据分割:将数据分割成训练集和测试集至关重要。这种做法允许您使用一部分数据训练模型,并在另一个未见过的子集上测试其性能,从而对模型进行无偏评估。
让我们考虑一下之前创建的数据集作为实践示例:
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error

# Load the dataset
data = pd.read_csv('/mnt/data/linear_regression_scikit_learn_dataset.csv')

# Feature selection
X = data[['TV', 'Radio']]  # Independent variables
y = data['Sales']  # Dependent variable

# Split the data into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# Model initialization and training
model = LinearRegression()
model.fit(X_train, y_train)

# Model evaluation
y_pred = model.predict(X_test)
mse = mean_squared_error(y_test, y_pred)
print(f'Mean Squared Error: {mse}')
在这个例子中,我们首先通过选择相关特征(“电视”和“广播”广告预算)和目标变量(“销售额”)来准备数据。然后,我们将数据拆分为训练集和测试集,以确保能够公平地评估我们的模型。遵循这些步骤可以确保我们的模型稳健、准确,并能反映底层数据的真实情况。
使用 Scikit-Learn 实现线性回归
使用 scikit-learn 实现线性回归非常简单,并且体现了该库的简单性和强大功能。 scikit-learn 的 API 的清晰度使复杂的分析变得易于理解和访问,使数据科学家能够专注于见解而不是复杂的算法。
下载数据集!
步骤 1:导入库和加载数据 – 首先导入必要的库并加载数据集。我们将使用之前准备好的数据集:
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error, r2_score

data = pd.read_csv('/mnt/data/linear_regression_scikit_learn_dataset.csv')
步骤二:选择特征和目标 ——确定自变量(特征)和因变量(目标)。在本例中,“电视”和“广播”是特征,“销售额”是目标:
X = data[['TV', 'Radio']]  # Features
y = data['Sales']  # Target
步骤 3:将数据拆分为训练集和测试集 ——为了有效地评估模型的性能,请将数据拆分为训练集和测试集:
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
步骤 4:初始化和训练线性回归模型 – Scikit-learn 使模型初始化和训练变得异常简单:
model = LinearRegression()
model.fit(X_train, y_train)
步骤 5:进行预测并评估模型 – 模型训练完成后,现在可以对测试集进行预测并评估模型的性能:
y_pred = model.predict(X_test)
mse = mean_squared_error(y_test, y_pred)
r2 = r2_score(y_test, y_pred)

print(f"Mean Squared Error: {mse}")
print(f"R² Score: {r2}")
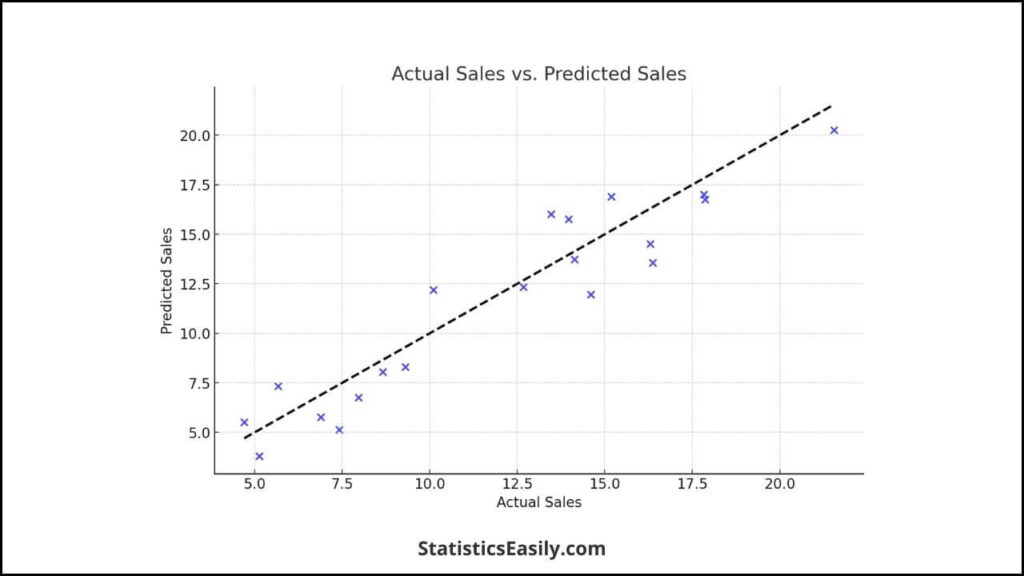
模型性能可视化 ——可视化呈现可以提供对模型性能的直观洞察。例如,绘制实际销售额与预测销售额的对比图:
import matplotlib.pyplot as plt

plt.scatter(y_test, y_pred)
plt.xlabel('Actual Sales')
plt.ylabel('Predicted Sales')
plt.title('Actual Sales vs. Predicted Sales')
plt.show()
这个简单的散点图提供了对模型预测准确性的快速视觉评估,距离线 y = x 更近的点表示性能更好。
通过这些步骤,scikit-learn 揭开了线性回归实现过程的神秘面纱,让初学者和经验丰富的从业者都能轻松上手。通过遵循本指南,您可以利用线性回归的强大功能,借助 scikit-learn 的 API 的清晰性和简单性,从数据中发现有意义的见解。
解释结果
解释回归模型的输出是分析过程中的关键步骤,可以深入了解变量之间的关系和模型的预测能力。在本节中,我们解释使用 scikit-learn 创建的线性回归模型,重点关注系数、模型指标和呈现研究结果时的道德考虑的重要性。
系数解释
线性回归模型中的系数表示在所有其他变量保持不变的情况下,自变量发生一单位变化时因变量的变化。在我们的模型中,“电视”和“广播”广告预算的系数表明它们各自对“销售”的影响。正系数表明存在直接关系:广告预算增加会导致销售额增加。相反,负系数表示反比关系。
模型指标
评估线性回归模型性能的两个关键指标是均方误差 (MSE) 和 R 平方 (R²) 值。
均方误差 (MSE)衡量的是误差平方的平均值,即估计值与实际值之间平方差的平均值。MSE 值越低,表明模型与数据的拟合度越好。
R²表示因变量的方差中可由自变量预测的比例,取值范围为 0 到 1。R² 值越接近 1,表明该模型能够解释因变量方差的很大一部分。
诚实的解释和道德考虑
在解释和呈现回归分析结果时,诚实和道德考虑至关重要。必须承认模型的局限性,包括任何可能不完全正确的假设或无法解释的变量。夸大模型的准确性或预测能力可能会导致错误的决策和误解。
数据源、预处理步骤以及选择特定变量背后的基本原理的透明度可以促进研究结果的信任和可信度。此外,每个数据科学家在道德上都有责任考虑这些发现对利益相关者的潜在影响,并确保这些解释不会误导或伤害。
解释线性回归模型的结果需要仔细检查系数和模型指标,并在呈现结果时承诺诚实和道德诚信。这种方法确保了分析的可靠性并维护数据科学的真实原则。
使用 Scikit-Learn 进行线性回归高级主题
为了完善线性回归模型并提高其预测准确性,出现了几种先进技术。这些方法解决了过度拟合等常见挑战,加深了我们对线性回归分析的理解,展示了其多功能性和深度。
正则化:减轻过度拟合的关键
Ridge(L2 正则化)和 Lasso(L1 正则化)等正则化技术可防止过度拟合。当模型在训练数据上表现良好但在未见过的数据上表现不佳时,就会出现这种常见的陷阱。通过在损失函数中引入惩罚项,正则化方法限制了系数的大小,从而防止模型变得过于复杂。
岭回归通过增加一个等于系数幅值平方的惩罚项,有效地缩小系数并降低模型复杂度。
Lasso 回归可以将一些系数减少到零,进行特征选择,并提供更易于解释的模型。另一方面,可以将一些系数减少为零,执行特征选择,并提供更易解释的模型。
在 scikit-learn 中实现这些很简单:
from sklearn.linear_model import Ridge, Lasso

# Ridge regression
ridge_model = Ridge(alpha=1.0)
ridge_model.fit(X_train, y_train)

# Lasso regression
lasso_model = Lasso(alpha=0.1)
lasso_model.fit(X_train, y_train)
The “alpha”参数控制正则化的强度,值越高,对系数的约束就越强。
模型评估和验证技术
评估和验证线性回归模型的性能对于确保其可靠性和准确性至关重要。交叉验证是一种稳健的技术,涉及将数据集划分为多个子集,并在某些子集上训练模型,同时在其余子集上测试模型。这种方法可以对不同数据段的模型性能进行更全面的评估。
from sklearn.model_selection import cross_val_score

# Cross-validation with 5 folds
scores = cross_val_score(model, X, y, cv=5, scoring='neg_mean_squared_error')
The scikit-learn 中的`cross_val_score`函数可以实现交叉验证,其中`cv`参数指定了折数。评分指标的选择,例如负均方误差,取决于分析的具体目标。
追求模型表现的真实性和准确性
通过正则化和交叉验证等技术推进线性回归分析时,坚持真实性和准确性的原则至关重要。正则化通过防止模型拟合噪声来解决模型的真实性。同时,交叉验证通过提供整体评估来确保模型性能指标的准确性。
数据发现的道德呈现,承认模型的局限性和潜在偏差,加强了分析的完整性。这些先进的技术和道德考虑确保线性回归分析仍然是数据科学家武器库中的强大工具,能够精确可靠地揭示见解。
在实际应用中使用 Scikit-Learn 进行线性回归
线性回归在 scikit-learn 领域的应用远远超出了理论构造,而是深深嵌入到现实世界问题解决的结构中。本节通过生动地说明线性回归在不同领域的应用,阐明了线性回归在 scikit-learn 中的实际用途,强调了数据科学对社会的变革性影响。
预测房价:线性回归最经典的应用之一是在房地产行业,它被用于根据房屋面积、位置、卧室数量和房龄等各种特征来预测房价。通过利用历史数据训练线性回归模型,房地产分析师可以估算房产的市场价值,从而指导买卖双方做出明智的决策。
销售额和收入预测:各行各业的企业都利用线性回归来预测销售额和收入,同时考虑广告支出、季节性趋势和经济指标。例如,零售公司可能会使用线性回归来了解广告活动对销售额的影响,从而实现营销预算的战略性分配,以最大限度地提高投资回报率。
医疗保健:预测疾病进展:在医疗保健领域,线性回归模型可根据患者的年龄、体重、血压和胆固醇水平等数据来预测疾病进展。该模型不仅有助于早期诊断和制定个性化治疗方案,还有助于高效分配医疗资源。
能源消耗分析:能源行业分析师利用线性回归,根据历史数据、天气状况和经济活动来预测能源消耗模式。这种预测性洞察对于能源生产和分配公司有效管理供需至关重要,有助于实现可持续能源管理。
成功案例:提升农业产量:线性回归在农业领域预测作物产量方面得到了显著应用,这是一个值得关注的成功案例。通过分析降雨量、温度、土壤质量和作物品种等变量,农艺师可以预测产量,从而优化农业实践,提高生产力。这有助于增强粮食安全,并通过最大限度地减少浪费和资源消耗来支持可持续农业。
这些现实世界的应用强调了 scikit-learn 线性回归在解决各个领域的复杂挑战方面的多功能性和实用性。通过利用数据的力量,线性回归模型阐明了做出富有洞察力的决策的道路,推动进步并对社会产生积极影响。通过这些叙述,我们见证了真、善、美原则在数据科学应用中的体现,重申了线性回归在塑造美好未来方面的深远作用。
广告标题
广告描述。 Lorem ipsum dolor sat amet,consectetur adipiscing elit。
结语
在穿越的景观中使用 scikit-learn 进行线性回归的过程中,我们深入了解了数据科学中最基础的技术之一——线性回归的理论基础和实际应用。线性回归以其简洁性和可解释性,成为预测和解释因变量与自变量之间复杂关系的灯塔。
本指南致力于让读者对 scikit-learn 框架内的线性回归有深入的了解,将理论基础与实践应用相结合。从最初研究线性回归模型的核心假设,到数据准备、模型构建和结果解释的实际练习,我们走过了一条理论与实践、洞察与应用相结合的道路。
事实证明,Scikit-learn 拥有丰富的工具和算法存储库,是这一旅程中的宝贵盟友。其用户友好的 API 和广泛的文档揭开了复杂统计分析的神秘面纱,使所有寻求解锁数据中隐藏模式的人都可以使用线性回归的强大功能。
本文重点介绍的现实世界应用——从预测房价到预测销售、推进医疗保健和优化农业产量——强调了线性回归在推动各行业明智决策方面的普遍影响。这些叙述展示了线性回归的实用性,并颂扬了数据科学在社会中的变革力量。
当我们结束这份综合指南时,我们的旅程并没有就此结束。线性回归领域,特别是在 scikit-learn 生态系统中,广阔且成熟,具有探索潜力。我鼓励您更深入地研究、试验您的数据集,并发现线性回归如何阐明未知、指导战略决策并为更大的利益做出贡献。
推荐文章
通过我们关于类似主题的其他深入文章探索更多见解并提升您的数据科学之旅。
- 什么是回归分析? 初学者综合指南
- 如何以 APA 风格报告多元线性回归的结果
- 如何以 APA 风格报告简单线性回归结果
- 线性回归的假设:综合指南
- 回归分析中如何计算残差?
- 线性回归分析:在 R 中绘制线条
常见问题解答 (FAQs)
问题1:如何使用Scikit-learn进行线性回归?使用scikit-learn的'LinearRegression'类可以高效地建模和预测自变量和因变量之间的关系。
Q2:什么是线性回归得分?该得分指的是预测的决定系数 R²,它衡量的是因变量的方差中可由自变量预测的比例。
Q3:如何在 Python 中导入线性回归?使用'from sklearn.linear_model import LinearRegression'从 scikit-learn 的 'linear_model' 模块导入 'LinearRegression' 类。
问题 4:Python 中线性回归的截距和系数是什么?截距是指当所有自变量均为零时因变量的值。系数是自变量值与因变量之间的乘积,代表它们与因变量之间的关系。
Q5:如何解释 Scikit-Learn 中的线性回归系数?系数表示在其他变量保持不变的情况下,每个自变量变化一个单位时,因变量的预期变化量。
Q6:什么是过拟合?如何解决过拟合问题?过拟合是指模型捕捉到的是噪声而不是潜在的模式。scikit-learn 中的交叉验证和正则化等技术可以缓解这个问题。
Q7:线性回归可以处理分类变量吗?使用独热编码等技术,可以将分类变量有效地纳入 scikit-learn 的线性回归模型中。
Q8:如何验证线性回归模型?验证包括使用交叉验证等技术,并评估 R² 和 RMSE 等性能指标,以确保模型的准确性和可靠性。
Q9:如何提高线性回归模型的准确率?提高准确率可以通过特征工程来实现,例如选择相关变量,以及应用岭回归或 Lasso 回归等正则化技术来减少过拟合并提高模型性能。
Q10:线性回归在现实世界中有哪些典型的应用?线性回归广泛应用于预测(例如销售和天气预测)、金融和保险领域的风险评估,以及科学研究中趋势和关系的评估,展现了其在各个领域的通用性。