广义线性模型 (GLM) 分布和链接函数选择指南
您将学习如何选择广义线性模型分布和链接函数以获得最佳建模精度。
介绍
广义线性模型 (GLM) 是传统线性回归模型的扩展,旨在适应各种数据类型和分布模式。这种灵活性使得 GLM 在数据科学家和统计学家的武器库中不可或缺。 GLM 的核心由三个主要组成部分组成:
- The 随机成分 指定响应变量的概率分布;
- The 系统组成部分 通过线性预测函数将预测变量与响应联系起来;
- The 链接函数 将分布均值与线性预测变量连接起来。
选择合适的广义线性模型分布和链接函数并非仅仅是技术决策,更是一门艺术,它能提升模型的准确性和预测性能。理解如何将分布和连接函数与数据的固有特征相匹配,是充分发挥广义线性模型潜力的关键,从而获得更具洞察力和可靠性的分析结果。本指南旨在阐明如何实现最佳模型配置,确保您的广义线性模型能够真正捕捉数据的本质。
核心亮点
- 选择正确的 GLM 分布可以显着提高模型精度。
- 链接函数将模型预测转换为响应变量的规模。
- 具有 Logit 链接的二项式分布非常适合二进制结果数据。
- 通过将分布与数据的性质相匹配来改进模型拟合。
- 迭代测试链接函数可以揭示最佳模型性能。
广告标题
广告描述。 Lorem ipsum dolor sat amet,consectetur adipiscing elit。
了解 GLM 分布
广义线性模型 (GLM) 是统计分析的基石,其灵活的框架使其能够处理各种类型的数据。GLMGLM 分布使这些模型超越传统线性回归的局限,接受超出正态的分布。本节深入探讨支撑 GLM 的各种分布。它指导您将数据与最合适的对齐GLM 分布.
不同数据类型的不同分布
GLM 专门设计用于处理不同的数据分布,每种数据分布都适合特定类型的响应变量。二项式分布经常用于二元结果,例如成功/失败场景。相比之下,泊松分布对于计算数据、解决“有多少?”至关重要。对于遵循正值的连续数据,伽马分布提供了一个拟合模型。每个分布都经过定制,以捕获底层数据结构的本质,确保模型的假设与数据的自然行为保持一致。
根据您的数据定制模型
选择合适的广义GLM 分布并非一成不变,而是一个需要细致考量的决策,它会显著影响模型的准确性和可解释性。关键在于理解数据的分布及其固有特征。例如,如果数据代表计数或比率,泊松分布可能是您的起点。相反,对于二元数据或比例数据,二项分布可能更合适。这一选择过程至关重要,因为它确保 GLM 能够反映生成数据的真实世界过程,从而增强模型的预测能力和可解释性。
通过精心匹配数据与正确的广义GLM 分布,您可以提升研究的分析严谨性,从而获得更精准、更有意义的洞见。这一基础步骤对于充分发挥 GLM 的潜力至关重要,使其能够揭示数据中隐藏的复杂信息。
链接函数在 GLM 中的作用
链接函数是广义线性模型 (GLM) 的关键,充当线性预测变量和响应变量的期望值之间的关键桥梁。它们的作用怎么强调都不为过,因为它们能够对超出传统线性回归能力的各种数据类型进行建模。通过将预测转换为响应变量的规模,链接函数可确保模型的输出遵循适当的数据范围和分布,从而提高模型预测的可解释性和准确性。
将预测转化为现实:链接函数的本质
连接函数并非一成不变;它们需要根据响应变量的性质和广义线性模型(GLM)所选的分布进行仔细选择。标准连接函数包括logit函数,它广泛用于二元数据的逻辑回归,将概率转换为无界连续尺度。恒等连接函数是正态分布模型固有的,它假设预测变量和响应变量之间存在直接关系。对数连接函数通常用于泊松分布的计数数据建模,确保模型的预测值保持为正且连续。
链接函数的应用:从理论到实践
链接函数的选择对于模型的应用和解释具有深远的影响。例如,在流行病学中,逻辑回归中的 logit 链接对事件发生的几率(例如疾病存在或不存在)进行建模。在经济学中,线性回归模型中的恒等联系根据教育和经验等预测因素直接预测收入等定量结果。与此同时,在保险领域,泊松回归模型索赔中的指数联系很重要,确保预测是非负的和离散的。
通过熟练地选择和应用适当的链接函数,统计学家和数据科学家可以制作 GLM,捕获数据中的潜在模式,并以准确且直观易懂的方式向受众传达他们的发现。本指南的这一部分揭开了链接函数的选择和应用的神秘面纱,为您提供了增强 GLM 的精度和可解释性的知识。
选择正确的分发和链接功能
选择适当的广义线性模型分布和链接函数对统计分析的成功至关重要。响应变量的性质以及响应变量与预测变量之间的关系决定了这一选择。本文将提供详细指南,帮助您顺利完成这一关键过程。
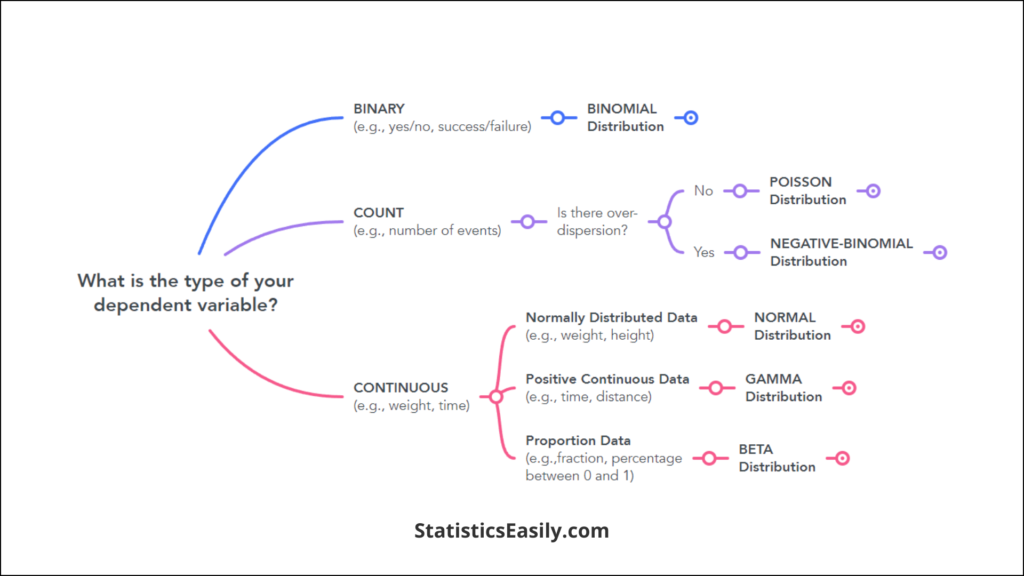
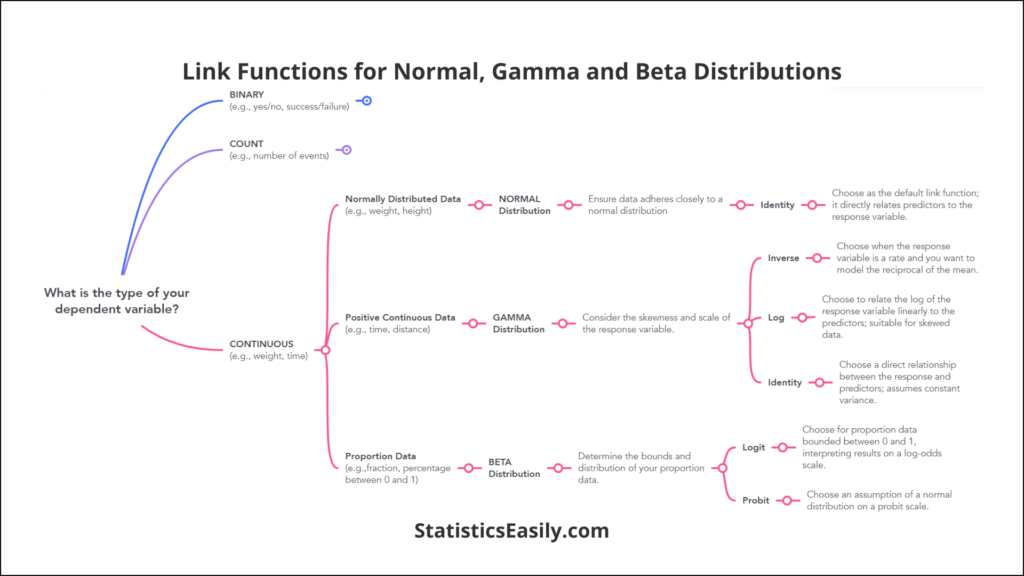
步骤 1:识别响应变量的类型
选择正确分布的第一步是清楚地识别您正在使用的数据类型:
- 二进制数据:对于属于两类之一的结果(例如,成功/失败、是/否),二项分布是首选。该分布模拟了一系列独立试验的成功次数。
- 计数数据:这个泊松分布通常在处理可计数的事件(例如,给定时间或空间内的事件数量)时使用。它非常适合表示计数且为非负整数的数据。
- 连续数据:这个伽马分布通常适用于取一定范围内任何值的数据,尤其是正数,例如持续时间或金额。它用于对正偏数据进行建模。
- 正态分布数据:当您的数据大致服从正态分布时,特别是在连续结果可以取正值和负值的情况下,正态分布可以在GLM框架内应用。
第 2 步:了解变量之间的关系
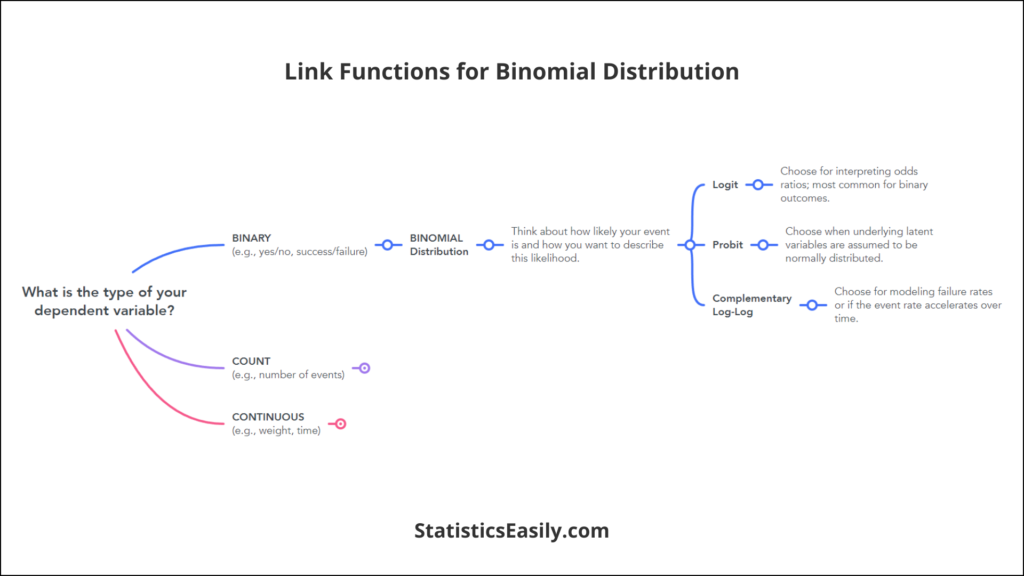
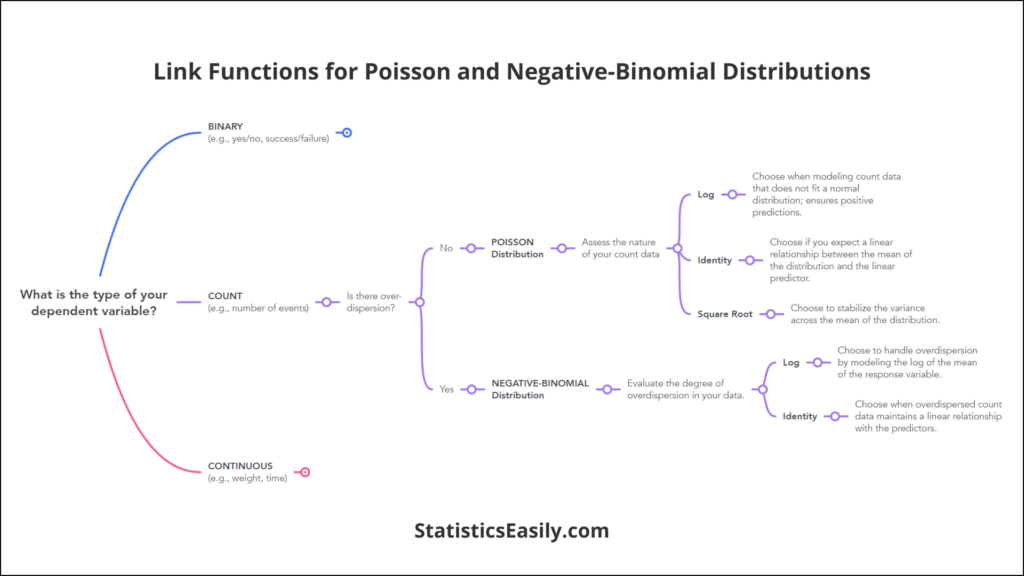
链接函数将线性预测变量连接到响应分布的平均值。应根据您预期预测变量的变化如何影响响应变量来选择它:
- 对于二进制数据:这个逻辑链接函数通常被使用,将预测变量的线性组合转换为介于 0 和 1 之间,从而表示概率。
- 对于计数数据:这个日志链接函数是一个自然的选择,特别是对于泊松分布,确保预测始终是正的并且非常适合计数数据。
- 对于具有正偏斜 (Gamma) 的连续数据:这个反向链接在对速率或时间进行建模时,函数可以很方便,确保积极的预测。
- 对于正态分布的数据:这个身份链接经常使用函数,它暗示预测变量和响应变量之间的直接关系。这个简单的函数意味着响应的预期值等于线性预测变量。
第 3 步:应用模型诊断
根据上述标准选择初步分布和链接函数后,通过模型诊断验证您的选择至关重要:
- 残留分析:检查残差是否存在可能表明拟合不佳的模式,表明需要不同的分布或链接函数。
- 拟合优度检验:利用偏差或 AIC 等测试来评估模型与数据的定量拟合程度。这些测试可以指导您比较不同的型号或配置以找到最合适的。
迭代细化
选择适当的分布和链接函数的过程通常是迭代的。根据诊断结果,您可能需要重新审视您的选择,尝试不同的分布或链接函数,直到诊断结果表明适合为止。
遵循这些详细步骤,您将能够更好地为 GLM 选择最合适的分布和链接函数,从而提高模型的准确性和可解释性。
| 响应变量类型 | 建议分配 | 常用链接功能 | 用例 |
|---|---|---|---|
| 二元结果(例如,成功/失败) | Binomial | Logit、Probit、互补对数-对数 | 对二元结果的概率进行建模,例如存在/不存在疾病。 |
| 计数数据(例如事件数) | 泊松分布 | 对数、恒等式、平方根 | 以固定时间间隔统计发生次数,例如呼叫中心每小时接到的呼叫数。 |
| 过度离散的数据计数 | 负二项式 | 日志、身份 | 计算表现出超过泊松假设的变异性的数据,例如每个客户的保险索赔数量。 |
| 连续比例 | 测试 | 罗吉特、概率 | 在 0 和 1 之间变化的比例,例如受特定条件影响的区域的比例。 |
| 积极的连续数据 | 伽马 | 逆、对数、恒等式 | 对等待时间或服务时间建模,其中响应变量始终为正。 |
| 正态分布数据 | 正态(高斯) | 身份 | 对称分布的连续结果,例如测试分数或身高。 |
GLM 优化的实用技巧
在中有效实现广义线性模型 (GLMs)R和Python中有效地实现广义线性模型 (GLM)需要理解这些强大工具的细微差别。通过合理利用广义线性模型分布和链接函数,您可以优化模型,从而获得更高的准确率和更好的可解释性。以下是一些实用技巧,可指导您完成此过程:
在 R 中实施 GLM 的最佳实践:
1. 使用‘glm()‘函数:R 语言的 'glm()' 函数功能强大,允许您指定模型公式、分布族和链接函数。例如,'glm(response ~ predictors, family=binomial(link=”logit”), data=mydata)' 将拟合一个逻辑回归模型。
2. 使用‘plot()‘和‘summary()` 进行诊断:拟合模型后,使用 `summary(glm_model)` 获取模型系数、显著性水平等的详细摘要。`plot(glm_model)` 函数可以提供诊断图,用于评估模型拟合度并检查假设。
3. 使用 AIC 进行模型选择:使用“step()”函数根据赤池信息准则 (AIC) 执行逐步模型选择,帮助您选择一个在复杂性和拟合优度之间取得平衡的模型。
4. 交叉验证:对于模型验证,可以考虑使用 boot 包中的 'caret' 或 'cv.glm()' 等包来执行交叉验证并评估模型的预测性能。
在 Python 中实现 GLM 的最佳实践:
1. 利用‘statsmodels‘或‘scikit-learn':Python 提供了多个用于实现广义线性模型 (GLM) 的库。对于更偏重统计分析的方法,'statsmodels' 提供详细的汇总和诊断信息。对于更偏重机器学习的方法,'scikit-learn' 则提供了简洁性以及与机器学习工作流程的集成。
statsmodels ”‘statsmodels:使用“statsmodels.api.GLM”拟合广义线性模型(GLM),并指定分布族和连接函数。例如,“GLM(y, X, family=sm.families.Binomial(sm.families.links.logit)).fit()”拟合逻辑回归模型。
3. 诊断和验证:使用“statsmodels‘ ”进行交叉验证等技术。sklearn.model_selection‘用于交叉验证等技术。
4. 特征选择:在 'scikit-learn' 中,您可以使用逻辑回归实现 ('LogisticRegressionCV') 中提供的正则化技术来执行特征选择并防止过拟合。
使用分布和链接函数进行模型细化:
迭代改进:模型构建是一个迭代过程。从一个简单的模型开始,逐步增加其复杂性。在每个步骤中使用诊断工具来评估模型的性能,并据此做出合理的修改决策。
分布选择:选择最符合响应变量性质的分布。对于二元结果,首先考虑二项分布;对于计数数据,如果存在过度离散,则考虑泊松分布或负二项分布。
链接函数选择:链接函数应反映线性预测变量与响应变量之间的关系。例如,在二项式模型中,概率数据应使用logit链接函数;在泊松模型中,计数数据应使用对数链接函数。
验证和诊断:定期进行模型诊断,检查是否存在非线性、高杠杆点或异方差等问题。使用残差图、影响图和库克距离来识别潜在问题。
广告标题
广告描述。 Lorem ipsum dolor sat amet,consectetur adipiscing elit。
结语
随着我们结束对复杂性的旅程广义线性模型分布和链接函数选择的深入探讨之际,重温那些能够提升统计模型精度和分析深度的关键见解至关重要。本指南阐明了如何充分发挥广义线性模型的潜力,并强调了将模型组件与数据固有特征相匹配的重要性。
关键要点:
定制化方法:广义线性模型(GLM)优化的精髓在于根据响应变量的性质及其与预测变量的预期关系,精心选择分布和连接函数。从需要二项分布和logit连接函数的二元结果,到最适合用泊松分布和对数连接函数建模的计数数据,每一个选择都对模型的准确性起着至关重要的作用。
诊断与迭代:模型构建之旅并非止于初始选择。诊断在模型优化过程中至关重要,残差分析和拟合优度检验可指导迭代调整,以确保获得最佳模型拟合效果。
实际应用:这些原则的真正考验在于它们在真实数据中的应用。广义线性模型(GLM)的通用性使其能够适应各种场景,从预测疾病发病率的流行病学研究到评估市场趋势的计量经济学模型。
推荐文章
浏览我们内容丰富的统计建模和 数据分析 文章合集,探索更多见解和高级技巧。跟随我们的专家指南,深入数据科学的世界。
常见问题解答 (FAQs)
问题1:什么是广义线性模型(GLM)?广义线性模型( GLM)是普通线性回归的灵活推广,它允许响应变量具有除正态分布之外的其他误差分布模型。
Q2:为什么在广义线性模型(GLM)中选择正确的分布很重要?选择合适的分布有助于准确地对数据进行建模,反映其潜在的结构和变异性。
Q3:广义线性模型中的连接函数是什么?连接函数定义了线性预测变量与分布函数均值之间的关系。
问题4:如何为我的广义线性模型选择合适的连接函数?连接函数的选择取决于因变量的性质和数据分布。
Q5:我可以在单个广义线性模型 (GLM) 中使用多个分布吗?通常情况下,GLM 会选择一个最能拟合数据的分布,但复杂的模型可能会整合多种分布。
Q6:广义线性模型中最常用的分布是什么?二项分布广泛用于二元数据,而正态分布则通常用于连续数据。
Q7:诊断在广义线性模型分布和连接函数选择中起什么作用?诊断有助于评估模型的拟合度,识别异常值,并指导选择过程。
Q8:软件工具能否帮助选择广义线性模型(GLM)的分布和连接函数?是的,是的,像统计软件 R 和 Python等统计软件提供了一些软件包,可以帮助选择和评估 GLM。
Q9:连接函数的选择如何影响模型解释?连接函数会影响模型系数的解释方式,进而影响洞见的清晰度和直接性。
Q10:模型拟合后可以更改分布和连接函数吗?可以,模型优化通常涉及迭代测试不同的分布和连接函数,以提高拟合度和准确性。