决策树:为有抱负的数据科学家从理论到 Python 实践
您将学习决策树的基本原理及其在 Python 中的实际应用,以获取数据驱动的见解。
介绍
决策树是的基石在 数据分析、数据科学和机器学习的基石,它提供了一个框架,通过其直观的结构简化了复杂的决策过程。这些模型将数据分解成易于理解的部分,使经验丰富的专家和新手都能清晰地发现模式和洞见。决策树的精妙之处在于它能够将复杂的数据集转化为视觉上易于理解且逻辑清晰的信息,从而促进明智的决策和预测。本入门探索将为在决策树在 Python, 指导有抱负的数据科学家从理论理解到实践应用。
核心亮点
- 决策树以无与伦比的简单性和准确性对数据进行分类。
- Python 的 scikit-learn 使决策树的实现变得简单。
- 决策树阐明复杂的数据,为决策提供清晰的路径。
- 优化技术可提高决策树的精度而不会过度拟合。
- 用 Python 可视化决策树揭开了数据分析过程的神秘面纱。
广告标题
广告描述。 Lorem ipsum dolor sat amet,consectetur adipiscing elit。
理解决策树
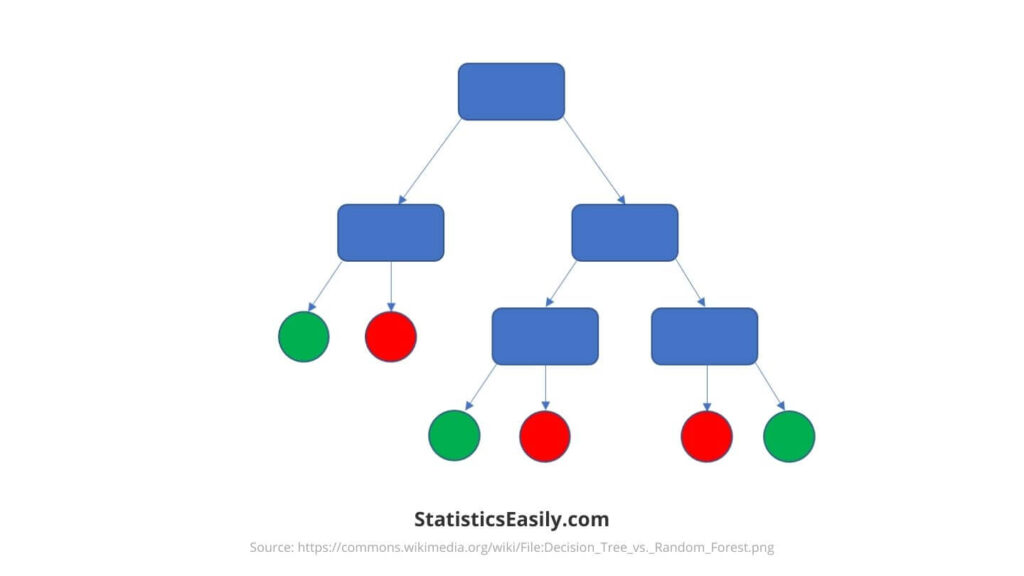
决策树是一种数据分析方法,它以层级结构呈现决策及其可能后果,包括随机事件结果、资源成本和效用。这种方法因其决策清晰性和可解释性而在数据科学领域备受青睐。
在其核心,决策树核心在于根据数据集特征中的决策标准将数据分割成多个分支。这些分割发生在节点上,第一个节点是树的根节点。每个节点代表一个决策点,分支代表该决策的结果,并由此进一步分割,直到叶节点代表最终结果或预测。
构建决策树包括确定每一步的最佳分割特征。这一决策基于多种指标,例如分类任务中的基尼不纯度或熵,以及回归任务中的方差缩减。这些标准有助于选择能够最有效地净化子节点的分割方案。
的深度决策树的深度衡量的是从根节点到叶节点的最长路径。更深的树可能对训练数据建模更精确,但也存在过拟合的风险——即模型在训练数据上表现良好,但在未见过的数据上表现不佳。相反,较浅的树可能过于简单,无法捕捉数据的底层结构,从而导致欠拟合。
决策树因其兼具简洁性和稳健性,能够对复杂的决策过程进行建模而备受青睐。它们既可以处理数值型数据,也可以处理类别型数据,因此用途广泛。此外,其结构便于可视化和解释,使其成为数据科学家交流研究成果的便捷工具。
理论基础的决策树的理论基础强调数据驱动决策的技术实现和清晰呈现。这与数据科学中追求真理和理解的目标相契合,阐明了如何剖析数据以揭示洞见,从而指导可操作且明智的决策。通过这种方法,数据科学家可以驾驭复杂的数据集,发现模式,并以兼顾精确性和简洁性的方式预测结果。
决策树在数据分析中的意义
在广义线性模型 (GLM) 中应用决策树的应用范围远超单一领域,在商业分析、医疗保健、金融等诸多领域展现出无与伦比的通用性。例如,在商业决策中,决策树可用于评估战略选择的潜在结果、风险评估和客户细分。医疗保健专业人员则利用决策树进行诊断预测、患者风险评估和治疗效果分析,从而为个性化医疗和改善患者护理提供指导。
一个关键优势是决策树的一项关键优势在于其可解释性。与许多如同“黑箱”般的复杂模型不同,决策树将决策过程可视化,使用户能够理解结论是如何得出的。这种透明性在医疗保健和金融等领域尤为重要,因为在这些领域,理解预测背后的逻辑与预测本身同样重要。
此外,与的易用性相关决策树的易用性也十分显著。它们无需大量的数据准备工作;可以直接处理分类数据和数值数据,而且参数之间的非线性关系也不会影响其性能。这种用户友好性确保了决策树能够被广大用户所接受,包括那些统计或编程经验有限的用户。
的优良性决策树在分析领域的优势在于其兼具简洁性和强大的预测能力。它们可以应用于回归和分类问题,是数据科学家工具箱中用途广泛的工具。此外,其结构便于应用剪枝等技术,从而有助于避免过拟合,并确保模型的稳健性和可靠性。
为决策树模型准备数据
数据准备是建模过程中至关重要的阶段,尤其是在使用决策树时。本节将深入探讨数据集准备的基本步骤:数据清洗以及将其拆分为训练集和测试集。每一步都旨在确保模型的完整性,并体现数据科学中对真理的严谨追求。
数据清洗包括识别和纠正数据集中的错误或不一致之处。这可能包括处理缺失值、删除重复项或纠正数据录入错误。对于决策树,确保数据准确无误至关重要,因为此类模型直接解释数据的结构和内容。干净的数据是构建可信赖且可解释模型的基础。
将数据拆分为训练集和测试集是评估将数据分为训练集和测试集是评估您有效性的关键步骤决策树模型有效性的关键步骤。数据通常会被随机划分,标准的划分比例为 70% 用于训练,30% 用于测试。训练集用于构建模型,而测试集则用于评估模型在未见过的数据上的性能。这一步骤对于评估模型的泛化能力至关重要,确保模型能够对新的、未见过的数据做出准确的预测。它是创建能够反映现实并值得信赖的决策模型的本质所在。
用 Python 构建你的第一个决策树
用 Python构建决策树可以揭开数据分析和机器学习的神秘面纱,即使是初学者也能轻松上手。本节将指导您使用Python创建您的第一个决策树使用 Python,强调实践经验和清晰性。
设置 Python 环境
确保您在计算机上安装了 Python。您可以从1. 请确保您的计算机上已安装 Python。您可以从python.org.
2. 使用 Python 的软件包安装程序 pip 安装必要的库。打开终端或命令提示符并运行:
pip install numpy pandas scikit-learn matplotlib
这些命令安装 NumPy 和 pandas 进行数据操作,安装 scikit-learn 进行机器学习,安装 matplotlib 进行可视化。
加载和准备您的数据集
1. 导入库并加载数据集。在本教程中,我们使用 Iris 数据集,这是一个可直接在 scikit-learn 中使用的简单但富有洞察力的数据集。
from sklearn.datasets import load_iris
import pandas as pd

iris = load_iris()
data = pd.DataFrame(data=iris.data, columns=iris.feature_names)
data['target'] = iris.target
2. 通过检查和处理缺失值或异常值来清理数据集。 Iris 数据集已经是干净的,因此这里不需要采取进一步的操作。
3. 将数据集拆分为训练集和测试集,以准确评估模型的性能。
from sklearn.model_selection import train_test_split

X = data.drop('target', axis=1)
y = data['target']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
使用 Scikit-learn 实现决策树模型
1. 从 scikit-learn 导入 DecisionTreeClassifier 并创建分类器的实例。
from sklearn.tree import DecisionTreeClassifier

dtree = DecisionTreeClassifier(random_state=42)
2. 使模型适合您的训练数据。
dtree.fit(X_train, y_train)
可视化决策树
1. 将训练好的决策树可视化,以了解它是如何做出决策的。
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

plt.figure(figsize=(20,10))
plot_tree(dtree, filled=True, feature_names=iris.feature_names, class_names=iris.target_names)
plt.show()
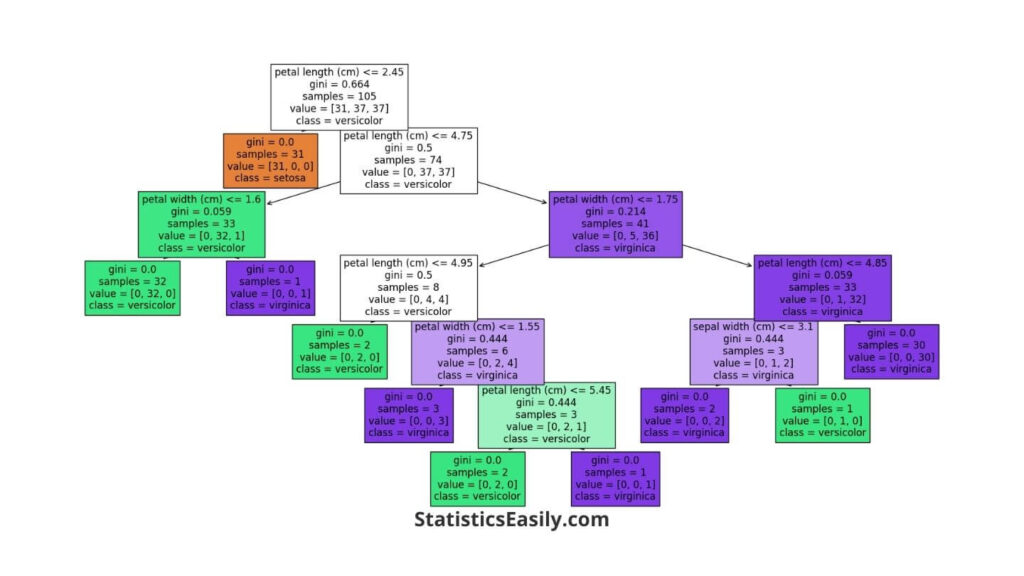
该图像表示经过训练将鸢尾花分类为三个物种之一的决策树模型。它基于 Iris 数据集,其中包括花瓣长度和宽度等测量值。以下是我们在此决策树中看到的内容的细分:
- 节点(矩形):每个矩形都是一个做出决定的节点。树从顶部的根节点开始,以叶节点结束。节点根据特定标准测试数据,例如花瓣长度是否小于特定值。
- 分支(连接节点的线路):这些线根据节点设置的标准引导从一个决策到下一个决策的路径。
- 叶节点(结束矩形):最终的节点(叶子)为我们提供了预测的类别(鸢尾花的类型)。它们不会进一步分裂,因为它们代表了模型可以利用给定数据做出的最明智的预测。
- 基尼系数(节点度量):基尼分数衡量纯度 - 0 表示完全纯净(节点中的所有样本都属于同一类),较高的分数表示节点内的类混合。
- 样本(在节点中):这告诉我们此时树中正在考虑多少数据示例。
- 值(在节点中):该数组显示了该节点样本中类的分布。例如,[0, 34, 2] 表示 0 个 setosas、34 个 versicolors 和 2 个 virginicas。
- 类(在节点中):这是模型在该节点的预测。决策树将用此类标记该节点中的任何数据点。
观察这棵决策树,我们可以从上到下追踪决策路径。例如,假设我们有一朵花瓣长度小于 2.45 厘米的鸢尾花。在这种情况下,决策树会将其分类为 setosa(如最左边的叶节点所示)。该树提供了一种透明的方式来准确查看模型如何根据输入特征得出结论。
实际例子
使用鸢尾花数据集,您可以轻松探索决策树的细微差别,而无需面对复杂的数据。该数据集简洁易懂,贴近实际应用,确保了学习的清晰度和趣味性,帮助您掌握Python 中决策树所需的知识和技能。
按照这些步骤,您已经创建并可视化了您的第一个决策树。从设置环境到分析简单的数据集,整个过程充分展现了 Python 机器学习的强大功能和易用性。决策树为各个级别的数据科学家提供了一种强大且易于理解的方法,无论是用于预测分析、数据探索,还是深入了解复杂的数据集。
评估和优化您的决策树模型
在 Python 中构建决策树模型后,接下来的关键步骤是评估和优化。这些过程可确保您的模型有效执行并做出准确的预测。
评估您的决策树模型
决策树模型的性能可以使用准确度、精确度和召回率等指标进行评估。准确度衡量正确预测的比例,精确度反映模型仅识别相关实例的能力,召回率表示模型找到数据集中所有相关案例的能力。
from sklearn.metrics import accuracy_score, precision_score, recall_score

predictions = dtree.predict(X_test)
print(f"Accuracy: {accuracy_score(y_test, predictions)}")
print(f"Precision: {precision_score(y_test, predictions, average='macro')}")
print(f"Recall: {recall_score(y_test, predictions, average='macro')}")
优化决策树的技术
优化决策树涉及调整参数以提高性能并防止过度拟合。关键技术包括:
剪枝:通过减少决策树的大小来移除分类能力较弱的部分。剪枝可以通过设置参数来实现,例如 `max_depth`(限制决策树的深度)和 `min_samples_split`(指定分割内部节点所需的最小样本数)。
dtree_optimized = DecisionTreeClassifier(max_depth=3, min_samples_split=5, random_state=42)
dtree_optimized.fit(X_train, y_train)
最大深度:限制树的深度有助于防止模型变得过于复杂和过拟合训练数据。
最小样本分割:设置节点分割所需的最小样本数有助于使模型更具通用性,并且不太可能拟合训练集中的噪声。
模型优化中的道德考虑
优化模型不仅仅是技术调整;它涉及道德考虑,特别是确保模型的预测是公平的并且不会延续偏见。过度拟合会影响模型对未见数据的准确性。它可能导致做出的决策可能无法反映数据或现实的真实性质。平衡模型复杂性与其可解释性和公平性至关重要,确保模型做出的决策合理且合乎道德。
确保模型准确反映现实强调了我们对真理的承诺。它涉及对不同数据集的严格测试,以检测和减少偏差。数据科学家肩负着道德责任,确保他们的模型服务于善,避免不准确的预测可能带来的伤害。
广告标题
广告描述。 Lorem ipsum dolor sat amet,consectetur adipiscing elit。
结语
深入探索决策树的复杂机制,揭示了这些模型在使数据科学变得易于上手且影响深远方面的强大能力。决策树兼具简洁性和深度,为我们提供了一个审视复杂数据集的视角,使做出明智的决策变得更加容易。本次从理论概念到Python实际应用的探索,突显了决策树的多功能性和强大功能,也充分展现了数据科学本身的魅力。
推荐文章
在我们的博客上发现更多数据科学领域的前沿技术和见解。深入研究决策树及其他内容,以全面理解并在项目中实际应用。立即探索!
- 描述统计和推论统计:简化数据分析
- Python 中的广义线性模型:综合指南
- Scikit-Learn 线性回归:综合指南
- P-hacking:可靠数据分析的隐藏威胁
- 使用 Scikit-Learn 进行逻辑回归 (故事)
- 5 年 2024 大免费数据分析工具
常见问题解答 (FAQs)
问题1:什么是决策树?决策树是用于数据科学中分类和回归任务的非线性预测模型。
Q2:为什么决策树在数据分析中很重要?它们能够提供对复杂数据集的直观、清晰的洞察,因此对于做出明智的决策至关重要。
Q3:Python 中如何实现决策树?Python 的库,例如 scikit-learn,可以方便地实现和可视化决策树。
Q4:决策树可以同时用于分类和回归吗?是的,决策树可以高效地处理这两种类型的任务,使其成为数据科学中用途广泛的工具。
Q5:决策树的独特价值体现在哪里?决策树的简洁性和可解释性,同时又不牺牲准确性,使其对分析师和科学家来说非常宝贵。
Q6:如何评估决策树的性能?使用准确率、精确率和召回率等指标,并结合对决策树本身的视觉检查。
Q7:决策树的主要挑战是什么?过拟合可能是一个挑战,需要剪枝等技术来控制树的复杂性。
Q8:决策树如何处理类别型数据和数值型数据?决策树本身就能处理这两种类型的数据,它会根据数据类型拆分节点,从而优化决策。
Q9:决策树中的剪枝是什么?剪枝通过移除树中对实例分类能力较弱的部分来减小决策树的规模。
Q10:如何在Python中可视化决策树?使用matplotlib和Graphviz等库,可以将决策树以可视化的方式呈现,以便更直接地进行解释。