随机森林实践:基本指南
您将了解随机森林如何利用决策树来提高复杂数据集中的预测准确性。
介绍
随机森林是一种重要的机器学习算法,因其在分类和回归任务中的高效性而在数据科学领域广受欢迎。其成功的关键在于能够在训练过程中构建多个决策树,并输出各决策树的类别众数(分类)或平均预测值(回归)。本入门指南旨在通过清晰易懂的步骤讲解,以及使用 Python实现随机森林的实用指南,帮助初学者揭开其神秘面纱。我们的目标是使读者掌握随机森林的理论基础,并能够利用 Python 强大的编程能力,将其有效地应用于数据科学项目中。
核心亮点
- 随机森林通过减少过度拟合而优于单一决策树。
- 随机森林中的超参数调整至关重要地提高了模型的准确性。
- 数据预处理对于随机森林的预测成功至关重要。
- 分步 Python 指南简化了随机森林的实现。
- 评估随机森林模型涉及准确性、精确度和召回率指标。
广告标题
广告描述。 Lorem ipsum dolor sat amet,consectetur adipiscing elit。
了解随机森林
随机森林是一种机器学习算法,它基于决策树的概念,旨在提供更准确、更稳健的预测模型。它在训练过程中会创建许多决策树,并输出类别,即分类问题中的类别众数或回归问题中各决策树预测结果的平均值。
随机森林的工作原理:
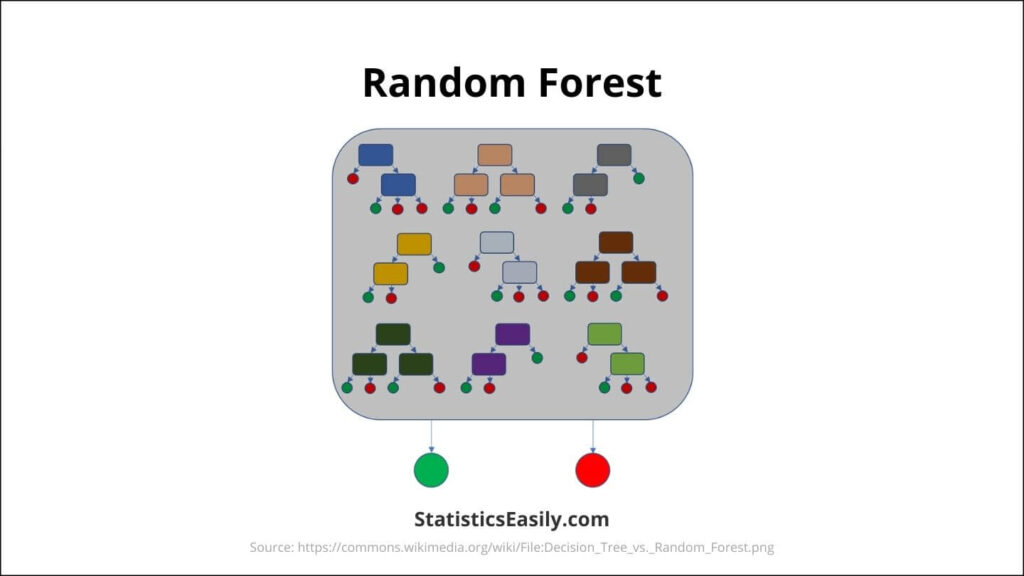
决策树:随机森林算法以决策树为基础,决策树是一种简单的树状决策模型。随机森林中的每一棵树都会给出一个预测结果,算法会取多数投票结果(如果是回归问题,则取平均值)作为最终输出。
自举法:该技术为每棵树随机选择数据集的一个子集,确保树之间的多样性,并有助于模型的稳健性。
聚合(Bagging):该算法将各个决策树的预测结果聚合起来,以产生更准确、更稳定的预测结果。
随机森林的优点:
降低过拟合风险:与经常容易过拟合训练数据的单个决策树不同,随机森林通过集成方法降低了这种风险。对多棵树的预测结果进行平均,确保模型的整体预测不会过度依赖于训练数据的任何单一部分,从而获得更具泛化能力的结果。
高精度:随机森林的优势在于它整合了多个决策树的预测结果,每个决策树都基于同一数据集的不同子集进行训练。这种集成方法显著提高了预测精度,在各种数据集和问题类型中均优于许多单一模型方法。
应用广泛:随机森林算法的设计使其能够在各种任务中表现出色,从分类问题中预测类别结果到回归分析中估计连续变量。它能够稳健地处理包含缺失值的数据集,并且无需大量预处理即可处理数值型和类别型数据,这使其具有极高的灵活性。
特征重要性洞察:随机森林的突出优势之一在于其固有的特征选择机制。通过分析每个特征对所有决策树预测准确率的影响,随机森林可以对数据集中特征的重要性进行排序。这种洞察对于理解预测背后的驱动因素至关重要,并可指导模型优化和 数据分析 过程中的特征选择。
随机森林的应用:
金融:随机森林算法在金融领域被广泛用于关键任务,例如通过分析信用评分来评估信用风险,预测股票市场的未来走势,从而辅助投资策略。
电子商务:该算法通过驱动推荐系统,根据用户行为和偏好推荐产品,从而提升在线购物体验。它在将客户细分为不同群体以进行精准营销和促销策略方面也发挥着关键作用。
医疗保健:在医疗领域,随机森林算法通过分析患者数据中提示特定疾病的症状,帮助早期发现疾病。它还有助于将患者分类到不同的风险群体,从而制定个性化的治疗方案。
网络安全:鉴于网络威胁日益复杂,随机森林算法利用数据模式中的异常检测,有助于及时发现和预测潜在的欺诈和安全漏洞,从而保护数字资产。
随机森林理论基础
随机森林算法基于集成学习的原理,将多个分类器(在本例中为决策树)组合起来,以解决复杂问题并提高模型的性能。
算法详解:
决策树集成:随机森林使用自助法技术,创建由不相关的决策树组成的森林,每个决策树都基于训练数据的随机子集进行训练。
随机特征选择:每棵树在每次分裂时都会选择一个随机特征子集。这种随机性有助于使树更加多样化,从而提高模型的整体准确率。
聚合:随机森林的最终预测结果由各个决策树的预测结果聚合而成。这种聚合方法可以降低方差,控制过拟合,并提高模型的预测精度。
超参数及其影响:
树的数量(n_estimators):增加树的数量通常会提高模型性能,但会增加计算成本。
最大深度(max_depth):控制每棵树的深度。更深的树可以捕捉更复杂的模式,但可能导致过拟合。
最小样本分割数 (min_samples_split):确定分割内部节点所需的最小样本数。较高的值可以防止模型学习过于具体的模式。
最大特征数(max_features):节点分裂时要考虑的随机特征子集的大小。它会影响森林中树的多样性。
衡量有效性:
准确性:正确预测的观测值占总观测值的比例。对于平衡分类问题而言,这是一个很有价值的指标。
混淆矩阵:模型性能的详细分解,包括真阳性、真阴性、假阳性和假阴性。
精确率、召回率和 F1 分数:精确率是指正确预测为正例的样本数与预测为正例的样本总数的比值。召回率(灵敏度)是指正确预测为正例的样本数与实际属于该类别的所有样本数的比值。F1 分数是精确率和召回率的加权平均值。这些指标在处理不平衡数据集时至关重要。
准备您的数据
有效的数据预处理是机器学习中的关键步骤,它会显着影响随机森林等模型的性能。本节概述了基本的数据清理和准备步骤,确保数据的结构适合随机森林建模。
数据预处理的重要性:
数据预处理将原始数据转换为可直接用于机器学习模型的干净数据集。这个过程至关重要,因为它直接影响模型的学习和准确预测的能力。对于涉及多个决策树的随机森林,预处理可确保整个数据集的一致性和质量,从而使算法能够更有效地识别模式。
数据清理和准备步骤:
1. 处理缺失值:随机森林在一定程度上可以处理缺失值。然而,最佳实践通常是使用均值插补法(针对数值特征)和众数插补法(针对类别特征)等策略来填补缺失值。
2. 对分类变量进行编码:通过独热编码或标签编码等编码技术将分类变量转换为数值格式,因为随机森林无法处理原始文本数据。
3. 特征缩放:虽然随机森林对特征缩放的敏感度不如 SVM 或 KNN 等算法,但确保所有特征都处于同一尺度有助于提高模型收敛性和特征重要性得分的可解释性。
4. 去除无关特征:剔除对预测无贡献或可能引入噪声的特征。虽然随机森林在训练过程中随机选择特征,但预先降低维度可以减少训练时间和复杂度。
分割数据集:
训练集和测试集:将数据分为训练集和测试集,以便评估模型在未见过的数据上的性能。典型的划分比例为 70:30 或 80:20,其中较大比例的数据用于训练。
交叉验证:考虑使用交叉验证技术,特别是 k 折交叉验证,以确保模型在不同数据子集上的性能一致。
Python 随机森林实际应用
在Python中应用随机森林算法可以有效地将算法的理论理解与实际编码技能结合起来。本节将指导您完成 Python 环境的搭建、使用sklearn库实现随机森林算法,并将其应用于真实数据集。
实际示例:预测鸢尾花种类
Iris 数据集包含 150 种鸢尾植物,根据四个特征分为三个物种:萼片长度、萼片宽度、花瓣长度和花瓣宽度。随机森林模型从训练数据中学习并准确预测鸢尾植物的种类。
按照以下步骤,您可以在 Python 中针对各种数据集(而不仅仅是 Iris 数据集)实现随机森林。调整模型的超参数(例如 n_estimators 和 max_depth),以根据您的特定数据集和任务提高性能。
提供的代码片段旨在简单易懂,并对每个步骤进行解释,以方便理解和实现。这一实际应用展示了随机森林在预测建模中的强大功能。它为探索更复杂的数据科学项目提供了坚实的基础。
设置 Python 环境
要在 Python 中使用随机森林,请确保您的计算机上安装了 Python。使用以下包:
- NumPy的:用于处理数组和矩阵。
- 熊猫:用于数据操作和分析。
- Scikit-learn(sklearn):提供随机森林算法和用于构建预测模型的附加功能。
- Matplotlib/Seaborn:用于可视化数据和模型结果。
使用 pip 安装这些包:
pip install numpy pandas scikit-learn matplotlib seaborn
使用 sklearn 实现随机森林
sklearn.ensemble 模块包括用于分类任务的 RandomForestClassifier 和用于回归任务的 RandomForestRegressor。以下是使用 RandomForestClassifier 的分步指南:
1.导入必要的库:
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
2. 加载数据集:本示例将使用 Iris 数据集,这是一个机器学习示例中的经典数据集。
from sklearn.datasets import load_iris
iris = load_iris()
X = iris.data
y = iris.target
3. 分割数据集:将数据分割成训练集和测试集,以评估模型的性能。
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
4. 初始化和训练模型:创建 RandomForestClassifier 实例并将其拟合到您的训练数据。
clf = RandomForestClassifier(n_estimators=100, random_state=42)
clf.fit(X_train, y_train)
5. 进行预测并评估模型:使用训练好的模型预测测试集并评估准确率。
y_pred = clf.predict(X_test)
print(f"Accuracy: {accuracy_score(y_test, y_pred)}")
模型结果和解释
训练模型并做出预测后,解释结果以了解其性能以及如何改进它至关重要。
评估模型性能:首先,检查模型的准确性,然后探索更多描述性指标。
# Model Accuracy
print(f"Model Accuracy: {accuracy_score(y_test, y_pred):.2f}")
混淆矩阵:混淆矩阵可以深入了解每个类别的正确和错误预测。
cm = confusion_matrix(y_test, y_pred)
sns.heatmap(cm, annot=True, fmt="d", cmap="viridis", xticklabels=iris.target_names, yticklabels=iris.target_names)
plt.xlabel('Predicted')
plt.ylabel('Actual')
plt.title('Confusion Matrix')
plt.show()
分类报告:分类报告包含每个类别的精确率、召回率和 F1 分数等指标。
print(classification_report(y_test, y_pred, target_names=iris.target_names))
特征重要性:了解哪些特征对模型的决策影响最大,可以帮助我们深入了解数据集。
feature_importance = clf.feature_importances_
sns.barplot(x=feature_importance, y=iris.feature_names)
plt.title('Feature Importance')
plt.show()
模型解释
准确度得分、混淆矩阵和分类报告共同提供了模型性能的全面视图。高精度表明该模型在分类鸢尾花物种方面的有效性,而混淆矩阵和分类报告详细说明了其跨类别的精度、召回率和 f1 分数。
特征重要性图揭示了鸢尾花的哪些特征(如花瓣长度或宽度)影响模型的分类决策。这种见解对于理解随机森林模型的决策过程和未来的特征工程或选择工作非常有价值。
通过解释这些结果,我们可以得出结论,随机森林分类器对此数据集非常有效,为预测建模任务提供了坚实的基础。使用不同的数据集进行试验或调整超参数可以增强模型的性能或对各种问题的适应性。
解释随机森林中的单个决策树
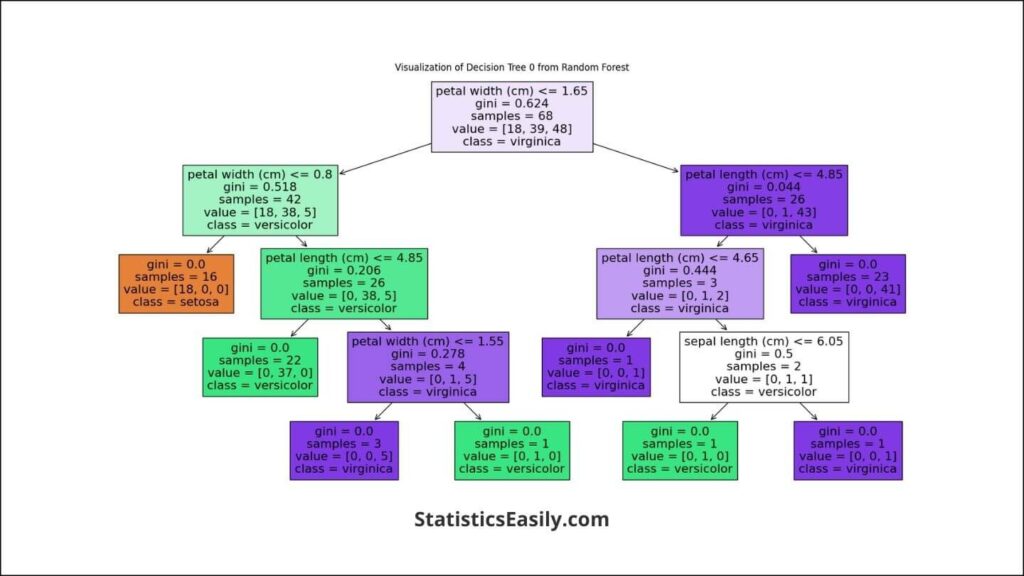
虽然随机森林是决策树的集合,但每棵树都会对结果做出贡献。可视化单个树可以更详细地洞察决策过程。让我们检查随机森林模型中的一棵这样的树:
可视化随机森林中的决策树:
# Visualize the first decision tree from the Random Forest
tree_index = 0
plt.figure(figsize=(20,10))
plot_tree(clf.estimators_[tree_index],
          feature_names=iris.feature_names,
          class_names=iris.target_names,
          filled=True,
          rounded=True)
plt.title(f'Decision Tree Visualization: Tree {tree_index}')
plt.show()
此可视化展示了随机森林中的单个决策树如何进行分类。它从顶部的根节点开始,然后根据特征值分成分支和决策节点,最后以代表类预测的叶节点结束。
分析树结构:
树中的每个节点代表基于特定特征值的决策。例如,节点可能根据鸢尾花的花瓣长度或宽度来分割数据。分支代表该决策的结果,导致新的决策节点或叶节点。当满足由从根开始的路径确定的一组标准时,叶节点提供最终的类预测。
这棵树的深度和复杂性表明了模型的分类策略。在实践中,随机森林结合了多个此类树的预测,以做出最终的、更准确的分类,从而利用每棵树的优势,同时弥补其弱点。
包含决策树可视化(例如上面生成的决策树可视化)可以通过允许读者可视化预测过程来丰富您的文章。它揭开了模型操作的神秘面纱,并提供了随机森林如何利用多个决策路径来达成分类决策的具体示例。
评估你的模型
使用 Python 实现随机森林模型后,下一个关键步骤是评估其性能。这涉及使用特定指标来了解模型对新的、未见过的数据的结果预测效果如何。本节涵盖关键的评估指标并提供模型改进和调整技巧。
如何评估随机森林模型的性能:
评估指标对于评估随机森林模型的准确性和有效性至关重要。以下是最常用的指标:
准确性:这是最直接的指标,计算方法是用正确预测的数量除以预测总数。虽然准确率很有用,但仅凭准确率可能会产生误导,尤其是在类别不平衡的数据集中。
精确度和召回率:当假阳性和假阴性的代价很高时,精确率(所有阳性预测中真正阳性结果的比例)和召回率(所有实际阳性结果中真正阳性结果的比例)至关重要,例如在医疗诊断或欺诈检测场景中。
F1 分数:F1 分数是精确率和召回率的调和平均值,它提供了一个单一指标来评估二者的平衡性。F1 分数的最佳值为 1(精确率和召回率均为 100%),最差值为 0。
混淆矩阵:用于描述分类模型在已知真实值的测试数据集上的性能的表格。它允许您可视化模型的预测结果,包括真阳性、假阳性、真阴性和假阴性。
解释结果:
了解这些指标可以让您准确地衡量模型的性能。例如,乍一看,高准确率可能看起来非常好。然而,通过精确率、召回率和 F1 分数进行进一步检查可能会揭示模型存在问题的领域,例如无法准确预测特定类别。
模型改进和调整的技巧:
超参数调整:随机森林模型有多个超参数,例如树的数量(n_estimators)和树的深度(max_depth),这些参数会显著影响模型性能。利用网格搜索或随机搜索方法可以帮助找到适用于特定数据集的最佳超参数组合。
特征选择:随机森林本身就能对特征的重要性进行排序。通过分析并剔除不太重要的特征,可以降低模型的复杂度并提高性能。
交叉验证:实施交叉验证(例如 k 折交叉验证)有助于确保模型在数据集的不同子集上的性能保持一致,从而提高模型的稳健性。
广告标题
广告描述。 Lorem ipsum dolor sat amet,consectetur adipiscing elit。
结语
本文提供了在 Python 中理解和应用随机森林的全面指南,涵盖其理论基础、数据准备、实际实现和模型评估。凭借其有效处理分类和回归任务的能力,随机森林仍然是数据科学家武器库中的强大工具,提供高精度和鲁棒性,防止过度拟合。鼓励尝试不同的数据集并面对各种预测建模问题强调了随机森林的多功能性和适应性。通过遵循从设置 Python 环境到评估模型性能的详细步骤,读者可以充分利用随机森林在其数据科学项目中,突破预测分析的界限。
推荐文章
查看我们的其他文章,探索有关数据科学主题的更多见解和教程。
常见问题解答 (FAQs)
Q1:什么是随机森林?它是一种用途广泛的机器学习方法,能够执行回归和分类任务,使用多个决策树并对它们的预测结果进行平均,以提高准确性并控制过拟合。
Q2:随机森林是如何工作的?随机森林创建了一个由随机决策树组成的“森林”,通过对结果进行平均或使用多数投票,使其预测比任何单个决策树都更准确。
Q3:为什么随机森林算法比其他算法更受欢迎?它之所以受欢迎,是因为它具有通用性,能够处理高维大型数据集,并且能够处理缺失值,从而使其能够有效防止过拟合。
Q4:随机森林的主要应用有哪些?它被广泛应用于银行、医疗、股票市场和电子商务等各个领域,用于欺诈检测、疾病预测、股票价格预测和客户细分。
Q5:如何为随机森林准备数据?数据准备包括数据清洗、处理缺失值、对分类变量进行编码以及将数据集拆分为训练集和测试集。
Q6:随机森林中的超参数是什么?它们如何影响模型?超参数会影响模型的复杂度和性能,例如树的数量、树的深度和最小样本分割数。调整这些参数可以显著提高准确率。
Q7:如何评价随机森林模型的有效性?标准评价指标包括准确率、精确率、召回率、F1 分数和混淆矩阵,这些指标有助于评价模型的预测性能和准确性。
Q8:使用随机森林有哪些挑战?随机森林虽然功能强大,但与更简单的模型相比,计算量可能很大,解释起来也更具挑战性,而且其性能可能对噪声数据很敏感。
Q9:如何调整随机森林模型以获得更好的性能?模型调优涉及调整超参数,例如树的数量、最大深度和最小样本分割数,可以通过网格搜索或随机搜索技术来找到最优设置。
Q10:随机森林可以处理类别型数据和数值型数据吗?是的,随机森林可以处理类别型数据和数值型数据的混合数据。它使用诸如独热编码之类的技术来处理类别型变量,使数据更适合建模。