异常值检测和处理:综合指南
您将学习异常值检测和处理的基本技术,提炼数据以获得真实的见解。
介绍
在数据科学中,异常值检测和处理是一个关键过程,保护 数据分析完整性和可靠性的关键步骤。这些异常值——即显著偏离正常值的数据点——会带来重大挑战,扭曲结果并导致错误的结论。检测和处理异常值不仅仅是优化数据,更是恪守科学研究的准确性和真实性原则。本指南旨在为数据科学家提供应对异常值复杂性所需的全面知识和工具,确保他们的工作符合最高的统计诚信标准,并为该领域的知识进步做出贡献。
核心亮点
- 异常值可能会严重影响数据分析,从而导致误导性的结论。
- Z 分数和 IQR 等统计方法是检测异常值的基础。
- 机器学习方法为复杂数据集中的异常值识别提供了先进的解决方案。
- 正确的异常值处理可以极大地提高模型的准确性和预测性能。
- 异常值处理中的道德考虑强调了数据科学的完整性。
广告标题
广告描述。 Lorem ipsum dolor sat amet,consectetur adipiscing elit。
了解异常值
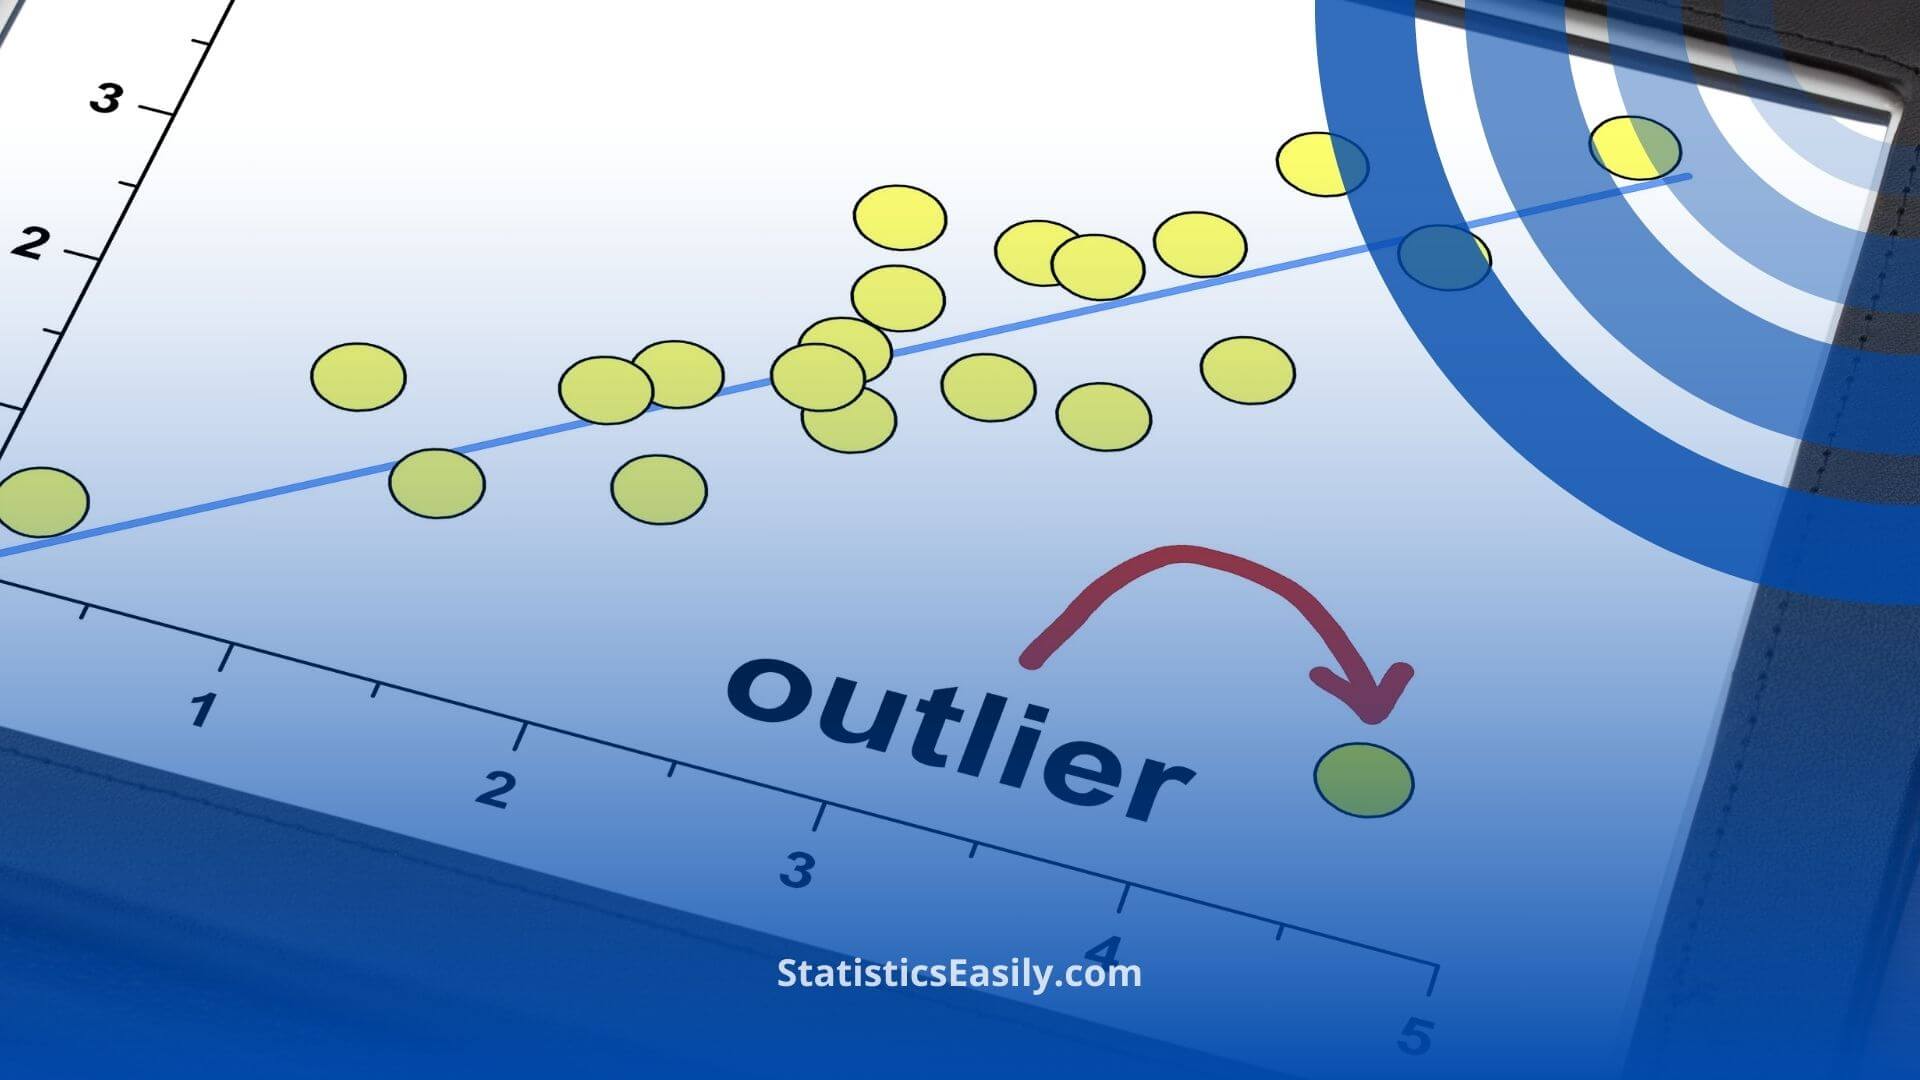
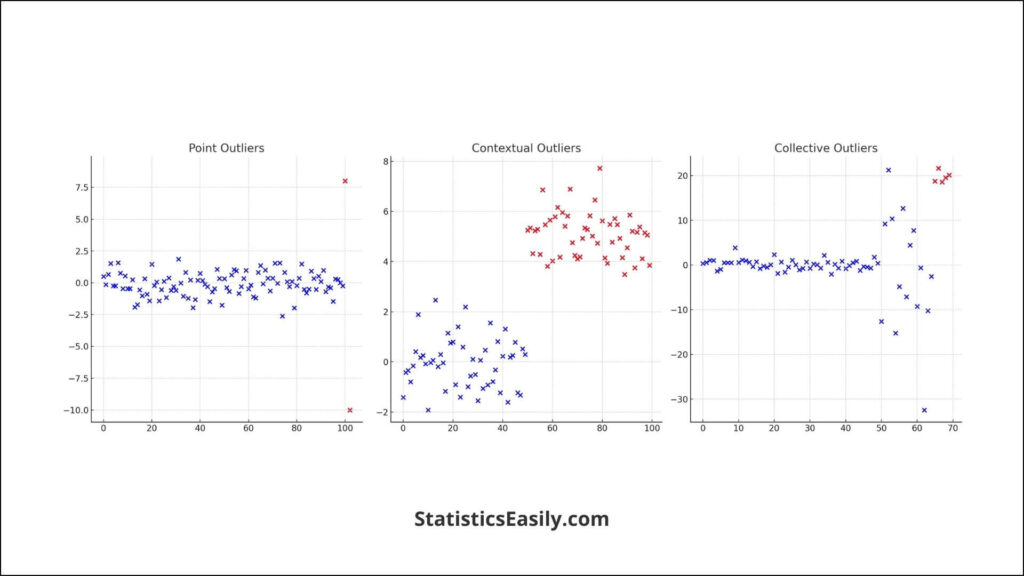
在数据科学中,异常值是指与数据集整体模式明显不同的数据点。这些异常值会对整体分析产生显著影响,导致结果偏差,甚至得出误导性的结论。异常值主要分为三种类型:点异常值,即与其余数据相距甚远的单个数据点;上下文异常值,即在特定上下文中被认为异常的数据点;以及集合异常值,即一组与整个数据集相比异常集中的数据点。
异常值分析的理论基础强调了异常值检测和处理在维护数据分析完整性方面发挥的重要作用。异常值可能会扭曲统计指标,例如平均值和标准差,从而影响数据分析的结果。例如,单个异常值可能会显着改变平均值,这可能会导致关于数据趋势和行为的错误结论。
理解和识别这些异常值对于任何稳健的数据分析过程都至关重要。通过适当地承认和解决异常值,数据科学家可以确保从数据分析中得出的结论是准确的并反映了基础数据的真实性质。此步骤不仅涉及数据清理,还涉及保留数据旨在表示的本质,从而在科学过程中遵守真实性和完整性的原则。
异常值的原因
数据集中的异常值可能源于多种因素,每种因素都需要仔细考虑才能进行准确的数据分析。测量误差是常见原因,仪器或人为误差会导致数据点与真实值相差甚远。数据录入错误是另一个重要来源,通常是由于打字错误或单位误读造成的,导致数据异常偏高或偏低。此外,数据的自然变异性也会产生异常值,尤其是在复杂系统中,会出现意料之外但真实的极端值。数据中的异常值可能会产生,特别是在发生意外但真实的极端值的复杂系统中。
考虑测量特定化学浓度的科学实验的情况。发生故障的光谱仪可能会报告异常高的浓度,这是由于测量误差导致的点异常值。在另一种情况下,当意外将额外的数字添加到读数中时,数据输入错误可能会引入异常值。最后,在记录人类身高的数据集中,异常高的个体代表自然变异,引入真实且反映人口多样性的异常值。
这些例子强调了辨别异常值本质的重要性。虽然本能可能是消除它们,但了解其原因可以提供更深入的见解。例如,化学浓度数据中的异常值会提示设备检查,以确保未来的准确性。身高数据集中异常高大的个体可能会对研究影响身高的遗传因素的研究人员感兴趣。
因此,消除异常值不应该是一个反射性的过程,而应该是一个深思熟虑的过程,考虑到背景和原因。这种方法确保数据分析立足于事实,准确反映潜在的现实,体现科学探究的完整性和彻底性原则。
检测技术
检测异常值是数据分析的重要步骤,可确保统计模型的准确性和可靠性。已经开发了各种方法来有效地识别这些异常。
统计方法:
Z 分数是检测异常值最常用的方法之一。该方法衡量数据点与均值之间的标准差个数。通常,Z 分数超过 ±3 的数据点被认为是异常值。
四分位间距(IQR)是指计算数据的第一四分位数(第 25 个百分位数)和第三四分位数(第 75 个百分位数)之间的范围。异常值则被定义为低于第一四分位数或高于第三四分位数 1.5 倍 IQR 的数据点。
格拉布斯检验(Grubbs' Test),即最大归一化残差检验,用于检测数据集中的单个异常值。该检验假设数据服从正态分布,最适用于仅怀疑存在一个异常值的情况。
机器学习方法:
机器学习提供了先进的技术来识别大型数据集中的异常值。诸如隔离森林和DBSCAN(基于密度的噪声应用空间聚类)等算法,通过考虑数据的分布和密度,在检测异常方面尤为有效。
实例探究:
异常值检测的一个显著应用是欺诈检测。金融机构利用机器学习模型来识别与客户消费模式显著偏离的异常交易,这些交易可能表明存在欺诈行为。
在医疗保健,异常值检测方法用于监测治疗的异常反应。例如,临床试验中药物的意外不良反应可能就是一个异常值,表明需要进行进一步调查。
领域环境科学领域也受益于异常值检测。研究人员可以识别和调查气候数据中的异常变化,例如温度或降水量的突然飙升,从而更好地了解气候变化动态。
治疗和处置策略
识别异常值只是数据分析的第一步。我们如何对待和处理这些异常值是一个关键决定,它会显着影响我们研究的结果和完整性。异常值处理策略包括去除、转换和插补,每种策略都有其应用背景和含义。
删除是最直接的方法,但应谨慎使用。删除数据点可能导致重要信息的丢失或结果偏差。这种方法通常用于处理明显的错误,或当异常值的影响远大于其相关性时。
转型是指运用数学函数来减少异常值引入的偏度。常见的变换包括对数变换、平方根变换或倒数变换。这种方法有助于数据分布的正态化,从而无需直接删除数据点即可进行更有效的分析。
插补用估计值替换异常值,通常采用中位数、均值或回归方法。当数据点被认为是错误的,但却能指示需要解决的潜在趋势时,这种策略是合适的。
道德考虑:
异常值处理决策的完整性必须得到平衡。每种策略都有其自己的位置,但选择必须在道德和科学上合理。因为不方便而删除数据点对追求真理提出了挑战,就像在不了解数据本质的情况下不加区别地进行转换或插补一样。道德实践要求对异常值的处理方式保持透明,并承认对分析结论的潜在影响。
例如,从污染数据中删除异常值而不调查其在环境科学中的原因可能会掩盖重大的生态威胁。同样,患者对医疗保健治疗的异常反应可能会揭示对副作用或新治疗途径的重要见解。
最终,异常值的处理和处理不应仅仅以更干净的数据或更舒适的分析途径为目标,而应反映出对发现和理解数据中潜在真相的承诺。这一承诺确保我们的工作以诚信和尊重我们寻求理解的现象的方式推进知识。
用于异常值检测的工具和软件
各种工具和软件已成为数据科学家在识别和管理异常值方面不可或缺的盟友。这些工具配备了复杂的算法和友好的用户界面,提高了异常值检测的准确性并简化了处理流程,从而坚持了对真理的科学追求。
Python 库:
- Scikit-learn:scikit-learn 以其全面的机器学习功能而闻名,提供了实用的异常值检测方法,例如隔离森林和局部异常值因子 (LOF)。它的多功能性和易于集成性使其成为数据科学家工具包中的主要内容。
- OD值:PyOD 是一个致力于异常值检测的专业库,包含多种检测算法,从 ABOD(基于角度的异常值检测)等经典方法到当代基于神经网络的模型。 PyOD 一致的 API 以及与 scikit-learn 的集成促进了无缝的分析体验。
R 包:
- 异常值检测:该软件包提供了检测和处理单变量和多变量数据中异常值的工具。它因其强大的统计技术和对各种数据类型的适应性而受到特别重视。
- 姆武特利耶: mvoutlier 专注于多变量数据,提供用于识别异常值的图形和统计方法。对于复杂数据集来说,它是一个重要的工具,在这些数据集中,异常值可能需要一段时间才能显现出来。
软件平台:
- KNIME:基于图形用户界面的软件,可实现复杂的数据分析工作流程,包括异常值检测。其模块化结构融合了经典的统计方法和先进的机器学习算法。
- 画面:Tableau 以其数据可视化能力而闻名,还包括主要通过视觉分析进行异常值检测的功能。此功能允许用户通过观察图形表示中的偏差来快速识别大型数据集中的异常情况。
—
异常值在预测建模和机器学习中的作用
异常值在预测建模和机器学习中占据着微妙的地位,在很大程度上影响模型的准确性和预测性能。了解他们的角色对于开发稳健且与其所代表的数据真实性一致的模型至关重要。
对模型准确性和性能的影响
异常值可以极大地影响预测模型的训练过程。例如,异常值可能会使线性回归模型中的回归线倾斜,导致模型在一般数据集上的性能较差。在聚类算法中,异常值可能会改变聚类中心,从而影响模型准确对数据点进行分组的能力。
处理模型训练中的异常值
在模型训练期间必须仔细考虑处理异常值的方法。选项包括:
- 排除:在训练之前从数据集中删除异常值,当异常值被确认为没有潜在意义的错误时,这可能是合适的。
- 转型:应用数学变换来减少数据点的范围可以使异常值不那么明显,并且可以在不彻底删除的情况下提高模型的稳健性。
- 稳健的方法:利用对异常值不太敏感的模型和算法,例如随机森林或稳健回归方法。
确保模型稳健且真实
模型训练的完整性在于平衡消除噪声和保留有价值的数据。真正的与变异性相关的异常值不应该被匆忙删除,而应该理解它们可能提供的见解。这种理解可以带来更准确、更能反映潜在现象的复杂性和真实性的模型。
处理异常值的指南
- 分析和文档:彻底分析异常值以确定其原因并记录有关其处理的决策。
- 验证:使用交叉验证技术来确保模型在未见过的数据上表现良好,并且异常值处理策略可以提高模型的通用性。
- 持续监控:即使在部署之后,也应持续监控模型,以确保它们在引入新数据时保持有效,其中可能包含新的信息丰富的异常值。
广告标题
广告描述。 Lorem ipsum dolor sat amet,consectetur adipiscing elit。
结语
异常值检测和处理是数据科学的关键,可确保数据分析的完整性和可靠性。它证明了数据科学家在其科学努力中致力于实现准确性和维护真理。正如我们所探索的,对异常值的仔细识别、分析和处理不仅可以完善我们的数据,还可以加深我们的理解,揭示否则可能会被掩盖的见解。这份全面的指南强调了在技术知识和道德考虑之间取得平衡来处理异常值的必要性,使我们的实践与揭示数据真相的更卓越的追求保持一致。让本指南激发人们对知识的持续探索以及在异常值治疗中应用道德原则,在科学界培育诚信和彻底的文化。
推荐文章
探索更多关于提高分析能力的信息。立即阅读我们有关高级数据科学技术的相关文章并提升您的知识!
常见问题解答 (FAQs)
问题一:数据分析中的异常值究竟是什么?异常值是指与其他观测值存在显著差异的数据点,可能会扭曲统计分析和结果。
问题二:为什么异常值检测和处理如此重要?识别和处理异常值对于准确的数据分析至关重要,能够确保模型反映真实的潜在模式。
问题3:异常值是否可以被视为有价值的数据点?异常值可以揭示数据收集中的新见解或错误,对其进行解读通常需要仔细分析。
问题4:检测异常值的标准方法有哪些?Z分数和四分位距(IQR)是常用的统计方法。
Q5:机器学习模型如何处理异常值?根据算法的不同,机器学习模型可能需要预处理以尽量减少异常值的影响,或者本身就能处理异常值。
Q6:异常值对预测模型有何影响?如果处理不当,异常值会使模型预测产生偏差,导致结果不准确或有偏差。
Q7:是否有用于异常值检测的自动化工具?一些软件工具和软件包专门用于检测和处理数据集中的异常值。
Q8:不同数据类型的异常值处理方法有何不同?处理策略可能包括 数据转换、删除或插补,具体取决于数据的性质和分析目标。
Q9:处理异常值时会涉及哪些伦理考量?伦理考量包括确保数据完整性,避免可能造成结果或结论偏差的操纵行为。
Q10:如何才能进一步提升我在异常值检测和处理方面的知识?参加高级数据科学课程、教程和实践项目可以加深对异常值分析的理解和技能。