


为什么你的数据可能出错:CS50 课程给数据专家的启示
本文将计算机科学的基本概念翻译成数据分析师和科学家能够理解的内容,展示了更深入地了解计算如何能够预防常见错误、解决性能问题并提高工作的可靠性。
引言:隐藏在眼皮底下的害虫
你肯定遇到过这种情况:数据管道莫名其妙地崩溃,脚本运行速度比预期慢几个数量级,或者 SQL 查询返回的结果感觉不对劲。你可能会把责任归咎于高级工具或数据本身的复杂性。然而,真正的罪魁祸首往往在于你的 Python 脚本和 SQL 查询所基于的基本计算机科学原理。如果你忽略了计算机实际运行的“底层”细节,就会在分析过程中引入难以察觉且难以诊断的错误。
本文基于YouTube上的CS50x 2025(哈佛大学)课程进行综合总结。文章提炼了第一讲C语言编程中几个极具价值的要点,这些要点可以直接应用于任何数据专业人员的日常工作中,帮助您构建更健壮、更高效、更准确的数据系统。
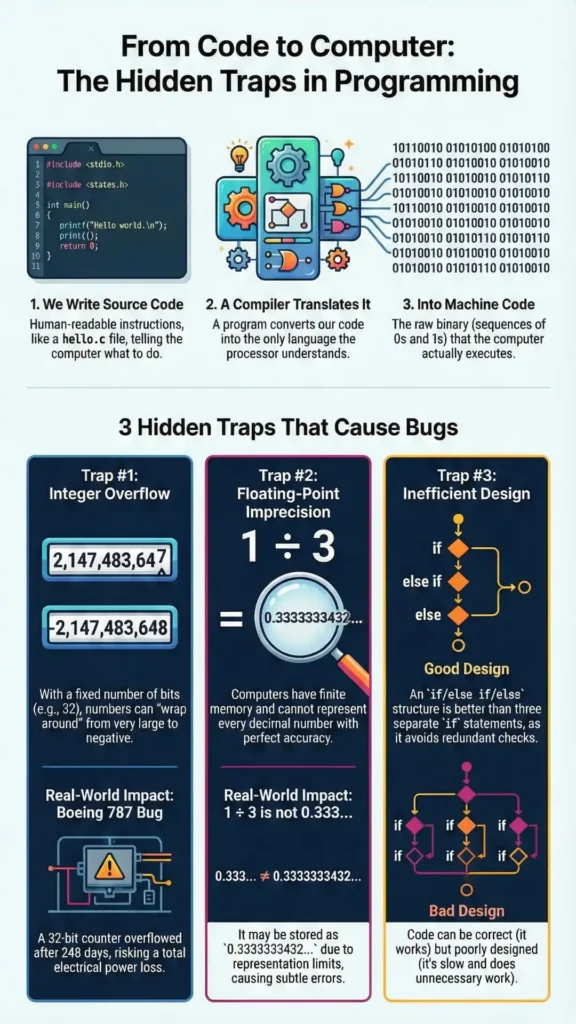
1. 源代码与机器代码:性能背后的“为什么”
计算机处理器的核心功能是只理解一种语言:机器代码,即一串由0和1组成的序列。你编写的代码,无论是Python、SQL还是C语言,都被称为源代码——一组人类可读的指令。为了弥合这种语言鸿沟,一种名为 编译器的 特殊程序会将你的源代码翻译成计算机实际可以执行的机器代码。
在讲座中, make hello command is used to compile a C source code file (hello.c) into an executable program (hello) composed of machine code. This compilation step is the key to understanding performance differences between programming languages and tools.
数据科学连接: 以我的经验来看,这是数据团队中最容易被忽视的性能瓶颈之一。像 Python 这样的解释型语言通常会隐藏这个编译步骤,但许多高性能数据科学库(例如 NumPy 或 pandas)都是用 C 等编译型语言编写的,这是有原因的。想想看…… for loop in pure Python to calculate a moving average over millions of rows—it could take minutes. The equivalent NumPy function, which calls pre-compiled C code, executes in milliseconds. That’s the performance gap we’re talking about. This is why you must understand this distinction to choose the right tools and avoid crippling bottlenecks in your data pipelines.
“计算机当然不理解源代码,它们只理解像0和1这样的二进制系统。所以我们必须想办法把原本看起来很晦涩难懂的东西,变成计算机能够理解的0和1,让它们看起来更加晦涩难懂。”——哈佛CS50x 2025(YouTube)——讲座:C
2. 命令行并非过时,而是强大。
你很可能通过图形用户界面 (GUI) 与计算机交互——也就是图标、窗口和鼠标点击的世界。命令行界面 (CLI),或者说终端,可能会让你感觉像是“倒退”到纯文本环境。然而,CLI 提供的强大功能、高效性和自动化程度是 GUI 无法比拟的,这也是为什么它仍然是许多开发人员的首选环境。
本次讲座将介绍构成文件系统导航和操作基础的一些基本命令: ls (list files), cd (change directory), mv (move or rename a file), and rm (remove a file).
数据科学连接: 对于严肃的数据工作而言,熟练掌握命令行界面 (CLI) 是必不可少的。它是您与存储数据和模型的远程服务器交互的主要方式。它对于使用调度工具(例如 cron 作业)自动化数据管道、管理 AWS 或 GCP 上的云资源以及使用 Git 等版本控制系统来确保工作可复现至关重要。图形用户界面 (GUI) 适用于本地探索,但自动化和可复现性都依赖于命令行。
3. 质量框架:正确性、设计与风格
代码评估并非简单的“能运行”或“不能运行”就能解决的。本次讲座提供了一个简单而强大的三步框架,用于评估任何程序的质量,该框架同样适用于 数据分析 脚本和 C 应用程序。
- 正确性: 这段代码能否产生预期的结果?如果让它计算平均值,它是否返回正确的数字?这是任何功能性代码的基本要求。
- 设计: 代码编写得如何?它是否高效且符合逻辑?讲座中举了一个糟糕的设计例子:显式地进行检查
if x == yafter you have already checked forx < y和x > y. Logically, equality is the only remaining possibility, so the final check is redundant. - 类型: 代码对其他人来说是否易读且美观?这包括诸如一致的缩进、清晰的变量名和逻辑间距等,这些对计算机来说没有影响,但对代码的可维护性却影响巨大。
数据科学连接: 这个框架是我在每次数据管道代码审查中都会用到的。管道可以是…… 正确 (它生成了正确的报告),但效果很差 旨在设计糟糕的流程可能会在三个不同的处理步骤中,在循环内从磁盘重新读取一个 10 GB 的 CSV 文件,而不是将其一次性读入内存。两者都“正确”,但前者速度慢几个数量级,成本也更高。同样,糟糕的流程也会导致…… 样式 在数据上下文中,这不仅仅是混乱的缩进;它指的是一个没有注释的 500 行 SQL 查询,以及名为 CTE 的语句。 temp1, temp2, and crucial business logic buried in a subquery six levels deep. It’s unmaintainable.
4. 不要重复自己:通过函数和库进行抽象
高效编程的核心原则之一是抽象:一次性解决问题,然后将解决方案打包以便复用。这避免了重复劳动,使代码更易于阅读和维护。本次讲座重点介绍两种主要的抽象形式。
第一种方法是使用 库包括这样一行: #include <stdio.h> 或 #include <cs50.h> grants a programmer access to a library of pre-written, pre-tested code. This means they can use powerful functions like printf (to print to the screen) without having to write the complex underlying code from scratch themselves.
第二点是创造 自定义函数举个简单但能说明问题的例子,讲座创造了一个 meow function to contain the logic of printing “meow” to the screen. By calling meow() three times instead of printf("meow") three times, the main part of the program becomes cleaner and more clearly expresses its intent.
数据科学连接: 这一原则是整个现代数据科学生态系统的基石。我们不会自己编写代码来创建数据框或从头开始运行回归;我们会使用 pandas、NumPy 和 scikit-learn 等库。在较小的范围内,你也必须将同样的思路应用到自己的工作中。如果你发现自己反复使用正则表达式从杂乱的文本字段中提取产品 ID,那么就应该将该逻辑封装起来。 def extract_product_id(text): function. Your main analysis script becomes cleaner, and that function can now be reused across multiple projects.
5. 价值十亿美元的漏洞:整数溢出
讲座中展示了一个强有力的演示:一个程序从数字 1 开始,反复询问用户是否要“将其翻倍并交给下一个人”。这个数字呈指数级增长到数十亿,然后突然变成一个很大的 负数 ,最终降至零。这并非代码的逻辑错误,而是计算机本身的根本局限性。
这种现象称为 整数溢出。计算机使用固定位数的比特(例如 32 位)来存储整数。一个 32 位整数只能表示大约 2 亿以内的数字。当你试图将 1 加到这个最大值上时,空间就不够了。比特会“回绕”,原本巨大的正数会变成巨大的负数,从而导致灾难性的、无声的错误。
这并非只是一个理论上的问题。讲座中提到了波音787飞机的一个实际问题:在连续运行248天后,用于跟踪时间的软件计数器会溢出,这可能导致飞机失去所有电力。
数据科学连接: 我经常看到初级分析师犯的一个经典且代价高昂的错误是忽略整数溢出的风险。因此,选择合适的数据类型至关重要。数据库管理员会谨慎选择数据类型。 BIGINT instead of INT for primary keys (like user IDs) that could one day exceed 2 billion. Imagine summing a transaction column that overflows; your final financial report would be dramatically, silently incorrect. Always be aware of the limits of the data types you’re using.
6. 电脑撒谎:浮点运算的不精确性
就像整数只有有限的位数一样,浮点数(带有小数点的数字,存储为 10 ... float 或 double). This leads to another subtle but critical issue: 浮点运算不精确性.
讲座提供了一个清晰的例子:当一个程序将 1 除以 3 时,结果并不是一个无穷级数。 0.333333.... Instead, it might be something like 0.3333333432... after a certain number of decimal places. The root cause is the same: with a finite number of bits, a computer cannot represent all possible real numbers with perfect accuracy. It stores a very close approximation, but the tiny difference can have major consequences.
数据科学连接: 忽略这一点会导致分析中出现难以察觉却又令人恼火的错误。一个简单的检查方法如下: if column_a == 0.3 might unexpectedly fail because the value is actually stored as 0.29999999999999998. These tiny errors can accumulate during complex calculations, potentially affecting statistical tests, model coefficients, or any task that relies on high numerical accuracy. The best practice is a hard rule: 决不要 不要检查浮点数是否完全相等;而是检查它们是否在彼此较小的容差范围内。
立即申请:五项要点清单
- 查看数据类型 在关键数据库表中。是一个
INTsufficient for a primary key that could grow beyond 2 billion? Consider upgrading toBIGINT. - 编写一个自定义函数 在下一个分析脚本中,处理重复的数据清理或转换任务,而不是复制粘贴代码。
- 使用代码格式化程序 (例如使用 Black for Python 或在线 SQL 格式化工具)自动改进下一个脚本的样式和可读性。
- 打开终端 并花五分钟时间,仅使用……浏览项目的文件结构。
ls(list) andcd(change directory). - 在下次代码审查中, 问一个关于设计的问题不仅仅是正确性。例如,“这个查询可以运行,但是这个逻辑能否简化以提高效率?”
关闭的思考
虽然内存分配和机器代码等概念看似与构建分类模型毫不相干,但它们却是所有可靠且健壮的数据系统赖以建立的基础。忽视这些概念就如同对一类潜在的错误和性能问题视而不见。CS50 课程将继续深入讲解这些底层概念,逐步过渡到更高级的语言和更复杂的问题。掌握这些基础知识是编写真正值得信赖的代码的第一步。
以下哪些“看不见的”计算细节最有可能在您未意识到的情况下影响您过去的某项分析?




