4个统计学真相将改变你对数据的看法
引言:超越数字
我们每天都身处数据海洋,将涌上岸边的图表和数字视为不容置疑的事实。我们看到报告或标题中的数字,往往会全盘接受,这影响了我们对从公共卫生到经济等方方面面的理解。
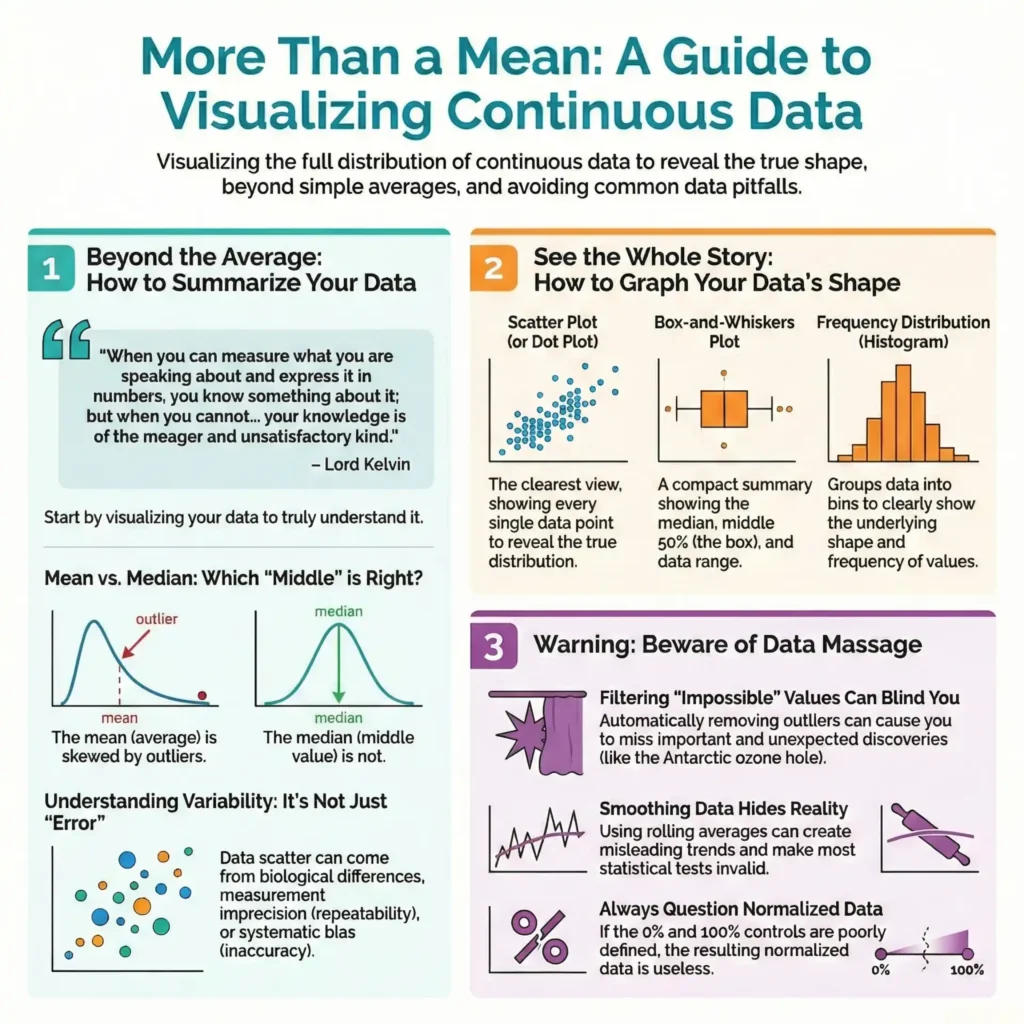
但从原始测量到最终完善的统计数据,这一过程充满了关键决策和隐藏的复杂性。数字本身并不能说明一切;它们是分析它们的人所讲述的故事的一部分。正如物理学家开尔文勋爵的名言所说,测量是知识的基础:
当你能够衡量你所谈论的事物并用数字表达它时,你就对它有所了解;但当你无法衡量它,无法用数字表达它时,你的知识就是贫乏且不令人满意的。
本文将揭开这一过程的神秘面纱。我们将揭示四个令人惊讶且影响深远的“幕后”统计概念,这些概念对于当今世界中任何从事数据工作或仅仅是使用数据的人来说都至关重要。
1. 并不存在“普通”的婚礼。
提到“平均值”,我们几乎总是会想到算术 意味着:所有数值之和除以观测值的个数。然而,衡量“中间值”的另一个重要指标是中位数,它指的是将所有数据按顺序排列后位于中间位置的值。
那么,美国婚礼的“平均”花费怎么可能既是 27,021 美元又是 16,886 美元呢?答案揭示了统计数据误导我们最常见的方式之一。2011 年,**平均**花费确实是 **27,021 美元**。但 中位数 位数却只有 $16,886。这种差异源于数据的分布。少数极其昂贵的婚礼拉高了平均值,使其无法代表大多数人的实际花费。而中位数则不受这些极端值的影响 异常值它更准确地反映了“典型”情况,因此对于像这样的偏态分布来说,中位数才是更有用的指标。
2. 在统计学中,“误差”并非错误
在日常用语中,“错误”一词指的是失误或做错事。然而,在统计学领域,这个词的含义却截然不同,而且更为中性。
在统计学中,“误差”是一个技术术语,其含义与“错误”截然不同,也更加中性。正如原文所述, “误差通常用来指代任何变异来源,是离散或变异的同义词。” 这种区别至关重要。当我们在数据集中观察到变异时——例如,一群健康人群的体温存在差异——这并非因为有人犯了错误。这种“误差”源于自然变异来源,例如个体间的生物学差异,或是实验测量固有的不精确性(或重复性)。将我们对“误差”的理解从“失误”转变为“变异”,使我们能够不再追问“谁搞砸了?”,而是开始提出更有意义的问题:“这种变异的自然来源是什么?”
3. “不可能”的数据如何拯救世界
数据处理的常见第一步是筛选并剔除“不可能”的值。例如,一个人的体重不可能为负数,死亡年份也不可能早于出生年份。剔除这些显而易见的错误看似简单合乎逻辑,但这种做法却隐藏着深远的风险。
臭氧空洞的故事是一个发人深省的警示。1985年,当研究人员首次注意到南极上空臭氧含量急剧下降时,他们的软件将这些数值标记为异常,因为这是有史以来观测到的最低值。研究人员本可以轻易地将这些数据点视为仪器故障或不可能的读数。但他们没有这样做,而是进行了深入调查,最终证实了仪器和计算的正确性。这促成了一项意义重大的发现:氯氟烃正在破坏臭氧层,并最终促使国际社会采取行动,防止全球环境灾难的发生。
这个教训意义重大。如果调查人员不加区分地排除这些“不可能”的值,他们就会犯下大错,错失一项重要的发现。
4. 建立在“调整”之上的趋势
我们在报告和新闻文章中看到的那些引人注目的图表,往往并非绘制实际收集的原始数据。更常见的情况是,它们展示的是经过调整、标准化或平滑处理的数据,目的是为了消除数据中的不一致之处,或使某种趋势更加明显。
想想全球变暖的权威图表——全球气温持续上升的趋势。这一趋势影响了国际政策,但它并非简单的温度计读数图表,而是一个经过一系列关键且大规模的统计调整而构建的故事。原始数据需要进行大量修正,以考虑诸如城市热岛效应(城市气温更高)、不同时期使用的温度计类型差异以及测量时间不一致等因素。这些修正的影响巨大。资料显示: “所有这些调整的最终结果是将早期气温数据下调了近1摄氏度,这与上个世纪观测到的气温上升幅度大致相当。”
这并非否定结论,而是揭示了一个关键的洞见:最终趋势是数据和科学判断共同作用的结果。这些调整是必要的,但需要仔细思考,而且不同的科学家可能会做出不同的调整。这凸显了在将数据转化为最终图表之前,始终询问数据是 如何 数据在转换为最终图形之前是如何处理的。
结论:提出更好的问题
从选择中位数而非平均值,到判断哪些数据真正“不可能”,再到确定如何调整外部因素,从数据收集到最终结论的整个过程都充满了人为的选择。统计数据并非仅仅是电子表格中呈现的客观事实;它们是经过深思熟虑、批判性判断和明智决策的过程的产物。
下次当你看到一张引人注目的图表或一个确凿的统计数据时,你首先会问的关于这些数字背后故事的问题是什么?